Showing posts with label ডাটা স্ট্রাকচার. Show all posts

Thursday, October 10, 2019

ডাটা স্ট্রাকচার - ১১ঃ হিপসর্ট

হিপ পদ্ধতি অবলম্বন করে যে ধরনের সর্ট করা হয় তাকেই হিপ সর্ট বলে। আমরা জানি হিপে রুট নোডটা থাকে সবচেয়ে বড়। হিপ সর্টে সেই রুট নোডটাকে সবার শেষের নোডের সাথে সোয়াপ করা হয়। তারপর শেষের নোডটা বাদ দিয়ে পুরো ট্রি টাকে আবার হিপে রুপান্তর করা হয়। এভাবে সোয়াপ এবং হিপে রুপান্তরের এক পর্যায়ে পুরো ট্রি টা সর্ট হয়ে যায়। নীচের সিমুলেশনটা খেয়াল করো-


সোয়াপ করার পর প্রতিবার আমরা শেষ থেকে একটা করে নোড বাদ দিয়ে বাকি অংশটাকে হিপিফাই করতেছি। এভাবে একটা পর্যায়ে গিয়ে পুরো ট্রি টাই সর্ট হয়ে যায়। কোডে রুপান্তর আরো সোজা-

 void heapSort(int heap[], int heapSize)  
 {  
   int i, temp;  
   buildMaxHeap(heap, heapSize); //Building heap  
   for(i = heapSize; i>1; i--)  
   {  
     temp = heap[1];  
     heap[1] = heap[heapSize];  
     heap[heapSize] = temp;  
     heapSize--;  
     maxHefipy(heap, heapSize, 1);  
   }  
 }  

Wednesday, October 9, 2019

ডাটা স্ট্রাকচার - ১০ঃ হিপ


হিপঃ হিপ হলো একটি কমপ্লিট বাইনারি ট্রি যে ট্রি এর প্রতিটি নোড তার চাইল্ড নোডের চেয়ে বড় বা ছোট থাকে থাকে। যদি বড় থাকে তাকে ম্যাক্স হিপ বলে আর যদি ছোট থাকে তাকে মিন হিপ বলে। এখানে আমরা শুধু ম্যাক্স হিপ নিয়েই ত্যানা পেঁচাবো। উপরে একটি ফিগার দেওয়া হলো-

একটি ট্রি কে অ্যারেতে স্টোর করার একমাত্র অসুবিধা হল কার চাইল্ড কে হবে তা আইডেন্টিফাই করতে না পারা। হিপ যেহেতু একটা কমপ্লিট বাইনারি ট্রি সে সুবিধা প্রয়োগ করে আমরা হিপকে একটা অ্যারেতে স্টোর করতে পারি এবং খুব সুন্দরভাবেই কোন ইন্ডেক্সের চাইল্ড কে তা বের করে আনতে পারি। উপরের ট্রি কেই অ্যারে আকারে লিখলাম ০ নাম্বার ইন্ডেক্স বাদ দিয়ে। খেয়াল করো।

এখন কোন ইন্ডেক্সের চাইল্ড কে হবে সেটি বের করতে পারলেই আমাদের সমস্যা শেষ। নীচের স্টেটমেন্টগুলো লক্ষ্য করো এবং অ্যারের ইন্ডেক্সগুলোর সাথে মিলিয়ে দেখো-

heap[0] = 0
heap[1] = 90
heap[2] = 85
heap[3] = 80
heap[2*2] = 70 // Left Child of 2
heap[2*2+1] = 60 //Right Child of 2
heap[3*3] = 55 //Left child of 3
heap[3*3+1] = 50 //Right Child of 3

সো, এখান থেকে এই জিনিসট স্পষ্ট যে কোন একটি ইন্ডেক্স যদি হয় i তাহলে তার লেফট চাইল্ড এর ইন্ডেক্স হবে i*i এবং রাইট চাইল্ড এর ইন্ডেক্স হবে i*i+1 । আবার তার প্যারেন্ট কে তার জন্য i কে দুই দিয়ে ইন্টেজার ডিভিশন করলেই কাজ শেষ । সো, এই কথাগুলোকেই কোডে আকারে লিখে ফেলি-

 int left(int i)  
 {  
   return 2*i;  
 }  
 int right(int i)  
 {  
   return (2*i)+1;  
 }  
 int parent(int i)  
 {  
   return i/2;  
 }  

নির্দিষ্ট কিছু ডেটাকে হিপ আকারে রাখার অ্যালগরিদমঃ

1. Find the left child and right child particular index
2. Find the biggest index between left, right and the particular index. Then swap the value of the biggest index and the particular index.
3. Do it until the biggest index is found in the left or right child


Pseudo Code:
 void maxHefipy(int heap[], int heapSize, int i)  
 {  
   int l, r, largest;  
   l = left(i);  
   r = right(i);  
   if(l<=heapSize && heap[l]>heap[i])  
   {  
     largest = l;  
   }  
   else  
   {  
     largest = i;  
   }  
   if(r<=heapSize && heap[r]>heap[largest])  
   {  
     largest = r;  
   }  
   if(largest!= i)  
   {  
     int temp = heap[i];  
     heap[i] = heap[largest];  
     heap[largest] = temp;  
     maxHefipy(heap, heapSize, largest);  // maxHefipy again from the largest index
   }  
 }  

একটি নোডের সবগুলো সাবট্রি যদি হিপ হয় সেক্ষেত্রে ওই নোডকে একবার কল করলেই এই অ্যালগরিদম দিয়ে পুরোপুরি হিপিফাই করা যাবে। উপরের চিত্রটি ভালোভাবে খেয়াল করলে বুঝতে পারবে।

কিন্তু ট্রি তে ডেটা যদি অন্যভাবে সাজানো থাকে তাহলে কিন্তু উপরের মত কাজ করবেনা। নীচের চিত্রে খেয়াল করো একবার কল করার পরই রিকার্সিভ কল বন্ধ হয়ে যাচ্ছে। কারন ৪ দিয়ে আর কল করা যাচ্ছেনা।


এই পরিস্থিতিতে maxHeapify() কে একাধিকবার কল করতে হবে। উপরের অ্যালগরিদমটাই N/2 বার কল করলেই পুরো ট্রি টা ১০০% হিপিফাই হয়ে যাবে। হিপিফাই করবো N/2 তম ইন্ডেক্স থেকে শূরু করে প্রথম ইন্ডেক্স পর্যন্ত। উপরের ট্রি এর ক্ষেত্রে এটা হবে 5/2 = 2 (ইন্টেজার ডিভিশন)। তো বুঝতেই পারছো এখানে আমাদের লুপ ব্যাবহার করতে হবে।

 void createMaxHeap(int heap[], int heapSize)  
 {  
   int i;  
   for(i = heapSize/2; i>=1; i--)  
   {  
     maxHefipy(heap, heapSize, i);  
   }  
 }  

নীচের সিমুলেশনটা খেয়াল করো-

কি! ক্লিয়ার না কোন ভেজাল আছে? ভেজাল থাকে কমেন্ট করে জানাইতে পারো। 

Thursday, October 3, 2019

ডাটা স্ট্রাকচার - ৪ঃ ডবলি লিংক লিস্ট

এর আগে আমরা যে লিংক লিস্ট নিয়ে কাজ করেছি সেখানে শুধু একদিক থেকে যাওয়া যায়। দুই দিক থেকে যাওয়া যায়না। যেমন ধরো, আমি ১০ থেকে শুরু করে লিস্টের ৫০ পর্যন্ত গেলাম। আবার ৫০ থেক শুরু করে যদি ১০ পর্যন্ত আসতে চাই তাহলে সিংগ লিংক লিস্টে সেটা সম্ভব না।


অথ্যাৎ, দ্বিমুখী না। দ্বিমুখী না হওয়ার কারন একটাই কারন আমরা প্রতিটা নোডে শুধু নেক্সট নোডেরই অ্যাড্রেস রাখি, এর আগে যে থাকবে সে  অ্যাড্রেসটা ধরে রাখিনা। ডবলি লিংক লিস্ট এমন ধরনের লিংক লিস্ট যেখানে প্রতিটা নোড একইসাথে নেক্সট জনের অ্যাড্রেস ধরে রাখে এবং প্রিভিয়াস জনের অ্যাড্রেসও ধরে রাখে। চিত্রে প্রথমটা সিংগলি লিঙ্ক লিস্ট পরেরটি ডাবলি লিঙ্ক লিস্ট। ডবলি লিঙ্ক লিস্টে আমরা দুই দিক থেকেই আসা যাওয়া করতে পারবো। 

ইমপ্লিমেন্টেশনঃ ইমপ্লিমেন্টেশন আগের মতই শুধু নোড তৈরী করার সময় Previous নোড রাখার জন্য একটা এক্সট্রা পয়েন্টার রাখতে হবে একইভাবে ডেটা ইন্সার্ট করার সময় Next Node এর পাশাপাশি Previous Node কে  হবে তা নির্দিষ্ট করে দিতে হবে।  বাকি সব আগের মতই। আমরা লিংক লিস্টের কোডটাই মডিফাই করে ডবলি লিংক লিস্ট আকারে লিখতে পারি-

 void inserEnd(int value)  
 {  
   if(sefuda == NULL)  
   {  
     person = (node*)malloc(sizeof(node));  
     person->data = value;  
     person->prev = NULL;  
     person->next = NULL;  
     sefuda = person;  
     current = sefuda;  
   }  
   else  
   {  
     person->next = (node*)malloc(sizeof(node));  
     person = person->next;  
     person->data = value;  
     person->prev = current;  
     person->next = NULL;  
     current = person;  
   }  
 }  


Sunday, August 26, 2018

ডাটা স্ট্রাকচার - ৩ঃ লিঙ্ক লিস্ট

অ্যারে বনাম লিঙ্ক লিস্টঃ

আমরা ইতোমধ্যে জানি যে, অ্যারে তে মেমরিগুলো পরস্পর সজ্জিত থাকে। অথ্যাৎ, অ্যারে একটা মেমরি ব্লক হিসেবে কাজ করে। সেই ভেরিয়েবলগুলোকে অ্যাক্সেস করার ক্ষেত্রে এই সুবিধাটা কাজে লাগানো হয়। যেহেতু অ্যারের ভেরিয়েবলগুলো পর পর মেমরিতে যায়গা নেয় সেহেতু প্রথম ভেরিয়েবলের অ্যাড্রেস পেয়ে গেলে আমরা সবগুলো পেয়ে যাই। চিত্রে খেয়াল করো-


লিঙ্ক লিস্টের কাজও মাল্টিপল ডাটা রাখা তবে কনসেপ্ট টা অ্যারের চেয়ে ভিন্ন। লিঙ্ক লিস্টে ভেরিয়েবলগুলো পাশাপাশি থাকেনা। কিন্তু পরে কোনটার পরে কোনটা থাকবে তা বলে দেওয়া থাকে। অথ্যাৎ, প্রতিটা ভেরিয়েবলে তার পরের জনের অ্যাড্রেস বলে দেওয়া থাকে। উপরের লিস্টই যদি আমি লিঙ্ক লিস্ট আকারে সাজাতে চাই তাহলে এমন হবে- 
এখানে ভেরিয়েবলগুলো পাশাপাশি থাকার কোন বাধ্যবাধকতা নাই। খেয়াল করো প্রতিটা নোডের দুইটা অংশ আছে। একটা অংশে তার ডাটা আর অন্য অংশে তারপরে কোন নোড থাকবে তার অ্যাড্রেস। প্রতিটা নোডেই এরকম ভেলু এবং তার পরের নোডের অ্যাড্রেস দেওয়া থাকে। যেহেতু যেকোন নোডে গেলেই পরের নোডের অ্যাড্রেস পেয়ে যাই সেহেতু আমরা সেই অ্যাড্রেস ধরে সবাইকে অ্যক্সেস করতে পারবো। বুঝতে সমস্যা হচ্ছে? দাঁড়াও বুঝিয়ে বলছি- 

মনে করো তোমরা ৪ বন্ধু- রহিম, করিম, রাকিব এবং সাকিব। একজন লোক তোমার বাড়ি অ্যড্রেস জানে। মনে করো লোকটার নাম সেফুদা। সেফুদাকে সবাই চিনে এবং মোটামুটি ওই এলাকার স্থায়ী। মনে করো ট্রাম্প নামের একজন ব্যক্তি তোমাদের সবার বাড়িতে আসতে চাচ্ছেন তথ্য সংগ্রহ করার জন্য। যেহেতু ট্রাম্প সেফুদাকে চিনে সেহেতু ট্রাম্প সেফুদার কাছ থেকে তোমার বাড়ির অ্যড্রেস টা জেনে নিলো। তারপর সেই অ্যড্রেস ধরে তোমার বাড়িতে চলে এলো এবং প্রয়োজনীয় তথ্য সংগ্রহ করলো। তোমার বাড়িতে আসার পর ট্রাম্প তোমার বন্ধুর অ্যড্রেস জিজ্ঞেস করলো তুমি রহিমের অ্যড্রেস বলে দিলে! তারপর তিনি রহিমের বাসায় গিয়ে করিমের অ্যড্রেস জানতে চাইলেন এবং চলে গেলেন করিমের বাসায়। তারপর রাকিবের বাসায় এবং শেষমেশ সাকিবের বাসায় গিয়ে আর কোন অ্যড্রেস পেলেননা এবং থেমে গেলেন। এভাবে সবার বাসায় তিনি চলে যেতে সক্ষম হলেন এবং সবার তথ্য সংগ্র করে ফেললেন। খেয়াল করো লোকটা কিন্তু এক এক করে তোমাদের সবার বাসায় চলে গেলো। এক্ষেত্রে তিনি কিভাবে গেলেন? তোমরা যে অ্যড্রেস বললে সেই অ্যড্রেস ধরেই! এখানে তোমরা তাঁকে দুইটা জিনিস দিয়েছো একটা হলো তোমাদের বাসার তথ্য যেটা ট্রাম্প সংগ্রহ করতে এসেছেন আরেকটা হল তোমার বন্ধুর অ্যড্রেস।  এখানে তোমরা প্রত্যেকেই একেকটি ভেরিয়েবল হিসেবে কাজ করেছো। লোকটার সবার বাড়িতে যাওয়ার পথ হল 
সেফুদা->রহিম->করিম->রাকিব->সাকিব। এই পথটা অন্য রকমও হতে পারতো। সেটা নির্ভর করে তোমরা কে কার অ্যড্রেস বলছো। 

উপরের আলোচনা থেকে এতটুকু স্পষ্ট যে, লিঙ্ক লিস্টে প্রতিটি ভেরিয়েবল দুইটা জিনিস বহন করতে হবে। একটা হলো আমাদের ডাটা/তথ্য এবং আরেকটা হল তার পরের ভেরিয়েবল অ্যড্রেস। তার মানে আমাদের ইন্টেজার ডাটা রাখার জন্য প্রতিটি ভেরিয়েবল একই সাথে একটা ইন্টেজার এবং একটা পয়েন্টার বহন করার সক্ষমতা থাকতে হবে। কিন্তু সি তে এমন কোন ডাটা টাইপ নাই যে একই সাথে ডাটা এবং পয়েন্টার বহন করে। আমরা জানি, ইন্টেজার শুধু একটা ইন্টেজার, ডাবল শুধু একটা ডাবল নিতে পারে।  সেক্ষেত্রে আমাদের একটি ডাটা টাইপ তৈরী করতে হবে যে একই সাথে একটি ইন্টেজার এবং একটি পয়েন্টার রাখতে পারে। সি তে ডাটা টাইপ তৈরী করার জন্য স্ট্রাকচার ব্যবহার করা হয়। 

 #include <stdio.h>  
 #include <stdlib.h>  
 struct Node  
 {  
   int data;  
   struct Node *next;  
 };  

নতুন যে ডাটা টাইপ তৈরী হল তা হচ্ছে- struct Node।  এটি এমন একটা ডাটা টাইপ যা একসাথে ইন্টেজার এবং একটা পয়েন্টার রাখতে পারে। কিন্তু আমরা চাইলে অন্যান্য প্রিমিটিভ ডাটা টাইপের মত (int, double, float) এক অক্ষরে করে নিতে পারি। এর জন্য আমাদের typedef নামক কিওয়ার্ড এর হেল্প নিতে হবে। এই কিওয়ার্ড দিয়ে একটা ডাটা টাইপকে রিনেম করার পদ্ধতি হল- 
typedef old_datatype new_datatype. যেমন উপরের struct Node কে যদি node এ কনভার্ট করতে চাই তাহলে লিখতে হবে- 

 typedef struct Node node  

এর ফলে node নামক একটি ডাটা টাইপ তৈরী হল যা দিয়ে আমরা এই টাইপের একটা ভেরিয়েবল ডিক্লেয়ার করতে পারি।

কথা হল- যেখানে অ্যারে আছে সেখানে এত ঝামেলায় যাওয়ার কি দরকার? আসলে অ্যারেতে কিছু সমস্যা আছে যে কারনে লিঙ্ক লিস্টের সুত্রাপাত।

যেমন ধরো, তুমি ১০০০০ স্টুডেন্ট এর তথ্য রাখার জন্য একটা সফটওয়্যার তৈরী করেছো। তুমি তথ্যগুলোগুলো ১০০০০ সাইজের একটা অ্যারেতে রেখেছো। তোমার তৈরী করা সফটওয়্যারটি ইউজারের কাছে চলে যাওয়ার পরে নিন্মোক্ত সমস্যার সম্মুখীন হতে পারে-
১। যদি কখনো ১০০০০ এর অধিক স্টুডেন্ট এর তথ্য রাখার দরকার পড়ে ইউজার তা করতে পারবেনা।
২। যদি ইউজারের স্টুডেন্ট কখনো ৫০০০০ এর অধিক না হয় তাহলে বাকি ৫০০০০ মেমরি অপচয় হবে
৩। ডাটাগুলো রিঅর্ডার করা কিম্বা মাঝখানে কোন ডাটা যুক্ত করা সময়সাপেক্ষ।

এই সমস্যাগুলো থেকে পরিত্রানের জন্য লিঙ্ক লিস্ট এসেছে। লিঙ্ক লিস্টে শুরুতে কোন ধরনের মেমরি এলোকেট করেনা। যখন দরকার হবে তখনই সে মেমরি এলোকেট করবে এবং ডাটা রাখবে। অথ্যাৎ, প্রয়োজন বেসিসে সে মেমরিতে যায়গা নিবে। যে পরিমান মেমরি দরকার সে সেই পরিমানই মেমরিতে যায়গা নিবে। এতে করে আমাদে উপরোক্ত প্রব্লেমগুলো সল্ভ হয়।
তো, ইতোমধ্যে আমরা জেনি  যে নোড নামের একটা ডেটা টাইপ আমাদের হাতে আছে। এই ডেটা টাইপ দিয়ে যদি কোন ভেরিয়েবল ডিক্লেয়ার করি সেই ভেরিয়েবল একইসাথে ডেটা রাখতে পারে এবং অন্য একটা নোডের অ্যাড্রেস রাখতে পারে। এই কথা বুঝতে পারলে লিংক লিস্ট ইমপ্লিমেন্টেশনের ৬০ ভাগ কাজ শেষ। উপরের গল্পটাকেই কোড আকারে লিখে ফেলি-

   node *Rahim, *Karim, *Rakib, *Sakib; //Declaring all node pointer variable to keep data  
   node *Sefuda, *Trump; //Declaring sefuda to keep the data of you/first person and Trump to travel all house  
   /*Allocating memory and keep data for all*/  
   Rahim = (node*)malloc(sizeof(node));  
   Rahim->data = 10;  
   Karim = (node*)malloc(sizeof(node));  
   Karim->data = 20;  
   Rakib = (node*)malloc(sizeof(node));  
   Rakib->data = 30;  
   Sakib = (node*)malloc(sizeof(node));  
   Sakib->data = 40;  
   Rahim->next = Karim; //Rahim can tell the address of next person Karim  
   Karim->next = Rakib; //Karim can tell the address of next person Rakib  
   Rakib->next = Sakib; //Rakib can tell the address of next person Sakib  
   Sakib->next = NULL; //There is no person after sakib. He tells NULL or none  
   Sefuda = Rahim;   //Sefuda knows the address of first person  
   Trump = Sefuda;   //Trump also knows the address of first person  
   /*Trump now visiting to all house */  
   while(Trump!= NULL)  
   {  
     printf("%d ", Trump->data);  
     Trump = Trump->next;  
   }  

এই কাজটাকে অন্যভাবেও করা যায়-
  sefuda = NULL; //Intially there is no person in the list. so, sefuda knows nothign  
   person = (node*)malloc(sizeof(node)); //create memory for first person  
   person->data = 10; //assigning data for first person Rahim  
   sefuda = person;  //Sefuda knows the first person  
   person->next = (node*)malloc(sizeof(node)); //creating memory for next person, Karim  
   person->next->data = 20; //Assigning data for Karim  
   person->next->next = (node*)malloc(sizeof(node)); //creating memory for next person Rakib  
   person->next->next->data = 30; //Assigning data for Rakib  
   person->next->next->next = (node*)malloc(sizeof(node)); //creating memory for sakib  
   person->next->next->next->data = 40; //assigning data for sakib  
   person->next->next->next->next = NULL; //There no person in next   
   //we can print all the data in same way  
   printf("%d ", person->data);  
   printf("%d ", person->next->data);  
   printf("%d ", person->next->next->data);  
   printf("%d ", person->next->next->next->data);  

অথবা এইভাবে -
 sefuda = NULL;  
   person = (node*)malloc(sizeof(node));  
   person->data = 10;  
   sefuda = person;  
   //person->next = (node*)malloc(sizeof(node));  
   //person->next->data = 20;  
   person->next = (node*)malloc(sizeof(node));  
   person = person->next;  
   person->data = 20;  
   //person->next->next = (node*)malloc(sizeof(node));  
   //person->next->next->data = 30;  
   person->next = (node*)malloc(sizeof(node));  
   person = person->next;  
   person->data = 30;  
   //person->next->next->next = (node*)malloc(sizeof(node));  
   //person->next->next->next->data = 40;  
   person->next = (node*)malloc(sizeof(node));  
   person = person->next;  
   person->data = 40;  
   //person->next->next->next->next = NULL;  
   person->next = NULL;  
   //we can print all the data in same way  
   printf("%d ", sefuda->data);  
   printf("%d ", sefuda->next->data);  
   printf("%d ", sefuda->next->next->data);  
   printf("%d ", sefuda->next->next->next->data);  

অথবা এইভাবে-
  int value, i;  
   sefuda = NULL;  
   for(i = 1; i<=4; i++)  
   {  
     scanf("%d", &value);  
     if(sefuda == NULL)  
     {  
       person = (node*)malloc(sizeof(node));  
       person->data = value;  
       person->next = NULL;  
       sefuda = person;  
     }  
     else  
     {  
       person->next = (node*)malloc(sizeof(node));  
       person = person->next;  
       person->data = value;  
       person->next = NULL;  
     }  
   }  

অথবা-
 int value, i;  
   sefuda = NULL;  
   for(i = 1; i<=4; i++)  
   {  
     scanf("%d", &value);  
     if(sefuda == NULL)  
     {  
       person = (node*)malloc(sizeof(node));  //creating first node   
       person->data = value;  //adding value   
       person->next = NULL;  //we don't know who is gonna next   
       sefuda = person; //let it know the sefuda/head that it is the first node   
     }  
     else  
     {  
       person = (node*)malloc(sizeof(node)); //allocating person for second node, which will replace previous value. No issue on that   
       person->data = value;  //adding value   
       person->next = sefuda; //next upcoming node will be pointing the sefuda/head  
       sefuda = person; //now second node became sefuda(first node) which pointing to the previous node   
     }  

Thursday, June 28, 2018

ডাটা স্ট্রাকচার - ২ঃ অ্যারের ভিতর বাহির


যদি তোমাকে বলা হয় ৫০ টা নাম্বার একত্রে যোগ করে দাও তাহলে তুমি কি করবে? তুমি কি আগের মত ৫০ টা ভেরিয়েবল ডিক্লেয়ার করে তারপর ইনপুট নিবে? কখনোই না। কারন এটা সময় সাপেক্ষ!

তাহলে আমাদের এমন একটা অবস্থা থাকা দরকার যা দ্বারা আমরা খুব দ্রুত অনেকগুলো ভেরিয়েবল ডিক্লেয়ার করে ফেলতে পারবো! হ্যাঁ, একটা ফিচার আছে যার নাম অ্যারে।  অ্যারে ডিক্লেয়ার করার নিয়মটা হল-  Data_Type variable_name[size]; নীচের উদাহরনটা দেখো-

int value[50];
এটা দেওয়ার সাথে সাথেই কিন্তু ৫০ টা ভেরিয়েবল ডিক্লেয়ার হয়ে গেছে। এই ভেরিয়েবলগুলো হল-
value[0],value[1],value[2],value[3],value[4],value[5],value[6],value[7],value[8],value[9].........value[49]
ব্র্যাকেটের ভেতরের সাইজ পরিবর্তন করে এভাবে আমরা যেকোন পরিমান ভেরিয়েবল তৈরী করে ফেলতে পারি। লুপ চালিয়ে খুব সহজভাবেই আমরা এর ভেতরে ডাটা রাখতে পারি এবং ডাটা দেখতে পারি।  নীচের প্রোগ্রামটি খেয়াল করো-

Program - 1: Input 5 numbers in an array and sum it

 #include <stdio.h>  
 int main()  
 {  
   int num[5], i, sum = 0;  
   for(i = 0; i<5; i++)  
   {  
     scanf("%d", &num[i]);  
   }  
   for(i = 0; i<5; i++)  
   {  
     sum+= num[i];  
   }  
   printf("Sum: %d\n", sum);  
   return 0;  
 }  

 Input:   
 10 20 30 40 50   
 Output  
 150  

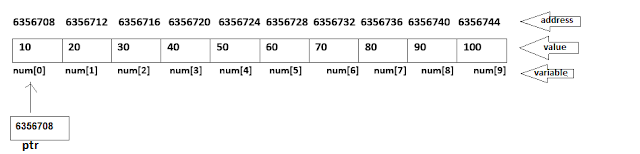
এখন কথা হল অ্যারে কিভাবে কাজ করে, অ্যারে ডিক্লেয়ার করার সাথে সাথে এতগুলো ভেরিয়েবল তৈরী হয় কিন্তু সেগুলো মেমরিতে কিভাবে থাকে? অ্যারে ব্যবহার জানলেও এটা সম্পর্কে আমাদের বেশিরভাগেরই ধারনা নাই।

অ্যারে সাইজ যতই হোক না কেন সবগুলো মেমরিতে একটা ব্লক  হিসেবে থাকে। মানে অ্যারের  সবগুলো ভেরিয়েবল পাশাপাশি থাকবে বা মেমরিতে পাশাপাশি যায়গা নিবে। আমরা নিচের প্রোগ্রামটিতে অ্যারের মেমরি অ্যাড্রেস প্রিন্ট করে দেখি। তাহলেই বুঝা যাবে। সেই সাথে আমরা নরমাল ভেরিয়েবলের মেমরি অ্যাড্রেস প্রিন্ট করে অ্যারে এবং সাধারন ভেরিয়েবলের মেমরি অ্যাড্রেসের পার্থক্য বুঝার চেষ্টা করবো-

Program - 1: Print the Memory of an array and normal variables 

 #include <stdio.h>  
 int main()  
 {  
   int i, num[10], sum = 0;  
   printf("Memory Address of array: ");  
   for(i = 0; i<10; i++)  
   {  
     printf("%d ", &num[i]);  
   }  
   printf("\n");  
   printf("Memory address of variables: ");  
   printf("%d %d\n", &i, &sum);  
   return 0;  
 }  

 Output:   
 Memory Address of array: 6356708 6356712 6356716 6356720 6356724 6356728 6356732 6356736 6356742 6356744  
 Memory address of variables: 6356748 6356724  

উপরে দেখা যাচ্ছে অ্যারের মেমরি অ্যাড্রেস একটা সিকুয়েন্স মেন্টেন করে চলছে। প্রতিটা মেমরি অ্যাড্রেসের পার্থক্য ৪ করে। কিন্তু ভেরিয়েবলের ক্ষেত্রে ব্যাপারটা অন্য রকম। আমরা যত ভেরিয়েবলই ডিক্লেয়ার করিনা কেন তা পাশাপাশি থাকবে কি থাকবেনা তার কোন গ্যারান্টি নাই। অথ্যাৎ, তাদের অবস্থান বা সিকুয়েন্স এর উপর আমাদের কোন নিয়ন্ত্রন নাই। যেটা অ্যারের ক্ষেত্রে পাওয়া যায়। অ্যারের সাইজ যতই হোক না কেন এটা যে নিশ্চিৎ যে সবগুলো ভেরিয়েবল পাশাপাশি অবস্থান করবে। এই অ্যারেটা যদি আমরা ভিজুলাইজ করি তাহলে এমন দেখাবে-
অ্যারের আরেকটা মজার বৈশিষ্ট্য হল অ্যারের নামটা পয়েন্টার হিসেবে কাজ করে এবং সেই পয়েন্টারে প্রথম ভেরিয়েবলটার অ্যাড্রেস থাকে। সেই অনুযায়ী উপরে num হল একটি পয়েন্টার এবং এর কছে num[0] এর অ্যাড্রেস থাকে। বিশ্বাস না হলে num[0] এর মেমরি অ্যাড্রেস এবং পয়েন্টারটা প্রিন্ট করে দেখো। 

অ্যারের এই বৈশিষ্ট্যটা কাজে লাগিয়ে আমরা ইন্ডেক্সিং এবং & ছাড়াই ডাটা ইনপুট এবং আউটপুট দেখাতে পারি। নীচের প্রোগ্রামটি খেয়াল করো- 

Program - 3: Input 10 numbers in an array and print it. Don't use any ampersand or array indexing 

 #include <stdio.h>  
 int main()  
 {  
   int i, num[10], sum = 0;  
   int *ptr = num;  
   for(i = 0; i<10; i++)  
   {  
     scanf("%d", ptr);  
     ptr++;  
   }  
   ptr = num;  
   for(i = 0; i<10; i++)  
   {  
     printf("%d ", *ptr);  
     ptr++;  
   }  
   return 0;  
 }  

 INPUT   
 10 20 30 40 50 60 70 80 90 100  
 OUTPUT  
 10 20 30 40 50 60 70 80 90 100  

এখন প্রশ্ন হল এটা আসলে কিভাবে কাজ করে? মনে করো তোমার বাড়ির পাশে সিরিয়ালি আরো ৯ টি বাড়ি আছে। তোমার বাড়িটা সবার প্রথমে। গনু মোল্লা নামের একজন লোক আছে যে তোমার বাসাটা চিনে।  এখন ধরা যাক ট্রাম্প নামক একজন ভিজিট করতে আসলো। কিন্তু ট্রাম্প দ্বিধায় পড়ে গেলেন। কোথা থেকে শুরু করবেন। ট্রাম্প আগে থেকেই জানতো সবগুলো বাড়ি সিরিয়ালি আছে এবং বুঝতে পারলেন প্রথম বাড়ির অ্যাড্রেস জানতে পারলেই খেলা ফাইনাল। তারপর ট্রাম্প নিক্কি হ্যালির পরামর্শক্রমে গনু মোল্লার কাছে গিয়ে প্রথম অ্যাড্রেসটা জানতে গেলেন। কারন তিনি জানেন গনু মোল্লা কখনো মিথ্যা কথা বলেনা। তারপর গনু মোল্লা সুন্দর করে তোমার বাড়ির অ্যাড্রেস টা বলে দিলো। ব্যাস খেলা শুরু হয়ে গেলো। ট্রাম্প সাহেব এক এক করে সবার বাড়ি ভিজিট করে ফেললেন।

এখানে num হল সেই গনু মোল্লা এবং ptr  হল সেই ট্রাম্প সাহেব। ট্রাম্প সাহেব তোমার এলাকায় আসার সাথে সাথেই গনু মোল্লা ptr = num দিয়ে জানিয়ে দিলো তোমার বাসার অ্যাড্রেস। তারপর কি হল সেটা তো তুমিই জানো।

একদম শুরুতে num এবং ptr প্রথম অবস্থানে থাকে এবং  ptr প্রতিবার এক এক করে  বাড়াতে বাড়াতে সবগুলো অ্যাড্রেসে যেতে পারছে এবং সেই পার্টিকুলার অ্যাড্রেসের ডাটা নিতে বা রাখতে পারছে। একে পয়েন্টিং বলা হয় আর ptr বা num কে পয়েন্টার বলা হয়। এভাবে একটা লিস্ট বা অ্যারের শেষ পর্যন্ত সে ট্রাভেল করতে পারে। এভাবেই অ্যারে কাজ করে। আশাকরি বুঝতে সমস্যা হয়নাই।

প্র্যাক্টিস প্রব্লেমঃ
১। ট্রাম্প যদি গনু মোল্লাকে নিয়েই সবগুলো বাড়িতে যেতেন তাহলে কি সমস্যা হতো, উত্তর জানাও কমেন্টে।

Friday, February 23, 2018

ডাটা স্ট্রাকচার - ১ঃ ভেরিয়েবল, মেমরি অ্যাড্রেসিং এবং অ্যম্পারসেন্ড সমাচার

ছবিঃ সংগৃহীত


প্রোগ্রামিং করার করতে হলে ডাটা নিয়ে কাজ করতে হবেই। ডাটা বলার সাথে ডাটা ম্যানেজ করা বা সংরক্ষন করার একটা বিষয় চলে আসে। আর এই ডাটা ম্যানেজমেন্ট বা ডাটা রাখার ভিবিন্ন পদ্ধতির উপর ভিত্তি করে নানান ধরনের ডাটা স্ট্রাকচার আবিষ্কার হয়েছে। এগুলোর মধ্যে বেশ কিছু হল অ্যারে, লিঙ্ক লিস্ট, স্ট্যাক, কিউ, ট্রি, গ্রাফ! একেকটা ডাটা স্ট্রাকচারের একেক ধরনের সুবিধা। কোনটা কখন ব্যবহার করতে হবে তা সম্পূর্ন পরিস্থির উপর নির্ভর করে। ভিবিন্ন ডাটা স্ট্রাকচারের পাশাপাশি ডাটা স্ট্রাকচারের আর্কিটেকচার এবং মেমরি অ্যাড্রেস সম্পর্কে ধারনা থাকা চাই। কারন ডাটা স্ট্রাকচার, ডাটা এবং মেমরি পরস্পর পরস্পরের সাথে জড়িত। ডাটা স্ট্রাকচার; ডাটা এবং মেমরির সাথে যোগসূত্র স্থাপন করে। এই পর্বে এসব নিয়েই আলোচনা হবে।

প্রোগ্রামিং করার সময় আমাদের ভেরিয়েবল ডিক্লেয়ার করার দরকার হয়। এটার সাথে আমরা সবাই পরিচিত।  এটা ভেরিয়েবল হল ডাটা স্টোর করার সবচেয়ে সহজ এবং মৌলিক একটি পদ্ধতি। যা অন্য সব ডাটা স্ট্রাকচারের "মা"! অন্য সব ডাটা স্ট্রাকচারের মুল ভিত্তি হল ভেরিয়েবল।  কিন্তু ভেরিয়েবল এতটা গুরুত্বপুর্ন কেন? কেন এত ঝামেলার করার দরকার? আবার ইনপুট নেওয়ার সময় Scanf এর ভিতর অ্যাম্পারসেন্ড কেন ইউজ করতে হয়? এসব নিয়েই আজ ত্যানা পেছানো হবে-

ভেরিয়েবল হল ডাটা স্টোর করার সবচেয়ে সহজ এবং মৌলিক একটি পদ্ধতি। যা অন্য সব ডাটা স্ট্রাকচারের "মা"! অন্য সব ডাটা স্ট্রাকচারের মুল ভিত্তি হল ভেরিয়েবল। ভেরিয়েবল ছড়া কি প্রোগ্রামিং করা যাবেনা? উত্তর হল হ্যাঁ!  কিন্তু বেশ কিছু সমস্যা তোমাকে ফেস করতে হবে যার ফলে তুমি বেশীদুর এগোতে পারবানা। নীচের দুইটা প্রোগ্রাম খেয়াল করো। যেখানে আমি দুইটা সংখ্যার যোগ করেছি। একটাতে ভেরিয়েবল সহ আরেকটাতে ভেরিয়েবল ছাড়া।

Program - 1: Adding two numbers with variables

  #include <stdio.h>      
  int main()   
  {   
   int a, b, total; //declaring three variable to keep the data   
   a = 20;   
   b = 30;   
   total = a+b;   
   printf("Total: %d", total);  
   return 0;   
  }   

 OUTPUT  
 Total: 50  

Program - 2: Adding two numbers without variables 

 #include <stdio.h>   
 int main()  
 {  
   printf("%d\n", 20+30);  
   return 0;  
 }  

 OUTPUT  
 50  

দুইটা প্রোগ্রামই একই কাজ করতেছে। খুব সুন্দর। এবার আমরা সমস্যাটার একটু পরিবর্তন আনি। ধরা যাক তোমাকে বলা হল ইউজারের কাছ থেকে দুইটা নাম্বার ইনপুট নিয়ে তা যোগ করো। এবার এই কাজটাও ভেরিয়েবল ছাড়া এবং ভেরিয়েবল সহ করার চেষ্টা করো-

Program - 3: Input two numbers from the user and Add it(With Variable)

  #include <stdio.h>     
  int main()    
  {    
   int a, b, total; //declaring three variable to keep the data    
   scanf("%d%d", &a, &b);  
   total = a+b;  
   printf("Total: %d", total);   
   return 0;    
  }   

 INPUT   
  10   
  20   
 OUTPUT   
  30   

Program - 3: Input two numbers from the user and Add it(Without Variable)

এই কাজটা কি আদো সম্ভব? ইউজারের কাছ থেকে ইনপুট নেওয়ার পর সেই নাম্বারটা আগে কোথাও সংরক্ষন করে রাখতে হবে। না রাখতে পারলে তো সেটা নিয়ে কাজ করা যাবেনা। আর ডাটাটা রাখার জন্যই ভেরিয়েবল বা কোন না কোন ডাটা স্ট্রাকচারের প্রয়োজন পড়ে। যে সিস্টেমের সাথে ইউজার ইন্টারেক্ট করতে পারবেনা সেই সিস্টেমের কোন দাম নাই। আর সেজন্যই ভেরিয়েবল ছাড়া প্রোগ্রামিং করার দৌড় এখানেই শেষ।

ভেরিয়েবল কিভাবে কাজ করেঃ

আমরা সবাই জানি ভেরিয়েবলে ডাটা রাখতে হলে প্রথমে ভেরিয়েবল ডিক্লেয়ার করতে হয়। তারপর ডাটা রাখতে হয়। কিন্তু জিনিসটা আসলে কিভাবে কাজ করে? আর ডাটা আসলে কোথায় যায়?

আমরা জানি কোন ডাটা রাখতে হলে মেমরির দরকার হয়। কিন্তু ভেরিয়েবলের কি কোন মেমরি আছে? সে কিভাবে ডাটা রাখে?  

আমরা যখন ভেরিয়েবল ডিক্লেয়ার করি তখন সে মেমরিতে যায়গা করে নেয়। আমরা আসলে ডাটা টা ভেরিয়েবলের মাধ্যমে মেমরিতে পাস করি। আমরা জানি যেকোন যায়গারই একটা অ্যাড্রেস থাকে। ভেরিয়েবল মেমরির কোন যায়গায়টা নিলো তারও একটা অ্যাড্রেস থাকে। ভেরিয়েবলের মেমরি অ্যাড্রেস দেখতে হলে তার আগে & দিয়ে প্রিন্ট করলেই দেখতে পাওয়া যাবে। এই অ্যাড্রেস হল একটা নাম্বার। নীচের প্রোগ্রামটিতে তিনটা ভেরিয়েবলের মেমরি অ্যাড্রেস দেখানো হয়েছে।

Program - 4: Check the memory address of two variables 

 #include<stdio.h>  
 int main()  
 {  
   int a, b, total;  
   printf("Memory Address of a: %d\n", &a);  
   printf("Memory Address of b: %d\n", &b);  
   printf("Memory Address of total: %d\n", &total);  
   return 0;  
 }  

 OUTPUT  
 Memory Address of a: 6356748  
 Memory Address of b: 6356744  
 Memory Address of total: 6356740  

এখানে & দিয়ে দুটো ভেরিয়েবলের মেমরি অ্যাড্রেস প্রিন্ট করেছি। মেমরি অ্যাড্রেসটা পিসি-পিসি ভেরি করতে পারে। তবে আউটপুট যাই আসুক সেটাই হল তোমার পিসির জন্য ঐ ভেরিয়েবলের মেমরি অ্যাড্রেস! উপরের আউটপুটটা আমার পিসির জন্য।

ইউজারের কাছ থেকে ভেলু গুলো ইনপুট নেওয়ার সময় আমরা আসলে মেমরি অ্যাড্রেসটাই দেখিয়ে দিচ্ছি। সেই অ্যাড্রেসে গিয়েই সিস্টেম ডাটা টা রাখে। সেজন্যই ইনপুট নেওয়ার সময় আমরা & ইউজ করি। ৩ নাম্বার প্রোগ্রামে খেয়াল করো ইনপুট নেওয়ার সময় আমরা ভেরিয়েবলের সামনে & ইউজ করেছি। scanf এর ভিতরে & ইউজ করার রহস্য আসলে এটাই।

যেহেতু & মেমরি অ্যাড্রেস রিটার্ন করে সেহেতু আমরা &a, &b না ব্যবহার করে তাদের যে মেমরি অ্যাড্রেস পেলাম তা ব্যবহার করি! তাহলে কি কাজ করবে? নীচের প্রোগ্রামটি খেয়াল করো-

Program - 5: Input two numbers directly to the memory address 

 #include<stdio.h>  
 int main()  
 {  
   int a, b, total;  
   scanf("%d%d", 6356748,6356744);  
   total = a+b;  
   printf("%d", total);  
   return 0;  
 }  

 INPUT  
 10  
 20  
 OUTPUT  
 30  

অবাক হচ্ছো? তুমিও তোমার ভেরিয়েবলগুলোর মেমরি অ্যাড্রেস দিয়ে ট্রাই করতে পারো। কাজ করবে। খেয়াল করো আমি কিন্তু এখানে কোন & ইউজ করিনাই। কারন আমিতো অলরেডি অ্যাড্রেসটা পেয়েই গেছি।

যাইহোক, আমরা চাইলে এই মেমরি অ্যাড্রেসটা অন্য একটা ভেরিয়েবলে রেখেই কাজটা করতে পারি। মেমরি অ্যাড্রেস রাখার জন্য এক ধরনের বিশেষ ভেরিয়েবল আছে সি তে। এটাকে পয়েন্টার বলে। পয়েন্টার ডিক্লেয়ার করতে হয় * দিয়ে! নীচের প্রোগ্রামটি খেয়াল করো-

Program - 6: Input two numbers using pointers  

 #include<stdio.h>  
 int main()  
 {  
   int a, b, total;  //declaring variable   
   int *p1, *p2;   //declaring pointer variable   
   p1 = &a;      //keep the address of a to p1   
   p2 = &b;      //keep the address of b to p2    
   scanf("%d%d", p1,p2); //input the value to the memory location   
   total = a+b;  
   printf("%d", total);  
   return 0;  
 }  

 OUTPUT  
 Total: 50  

 INPUT  
 10  
 20  
 OUTPUT  
 30  

খেয়াল করো। ইনপুট নেওয়ার সময় আমরা এখানেও আর & ব্যবহার করছিনা। কারন p1 এবং p2 এর মধ্যেই মেমরি অ্যাড্রেস আছে।

আজ এই পর্যন্তই। আশাকরি ভেরিয়েবলের মেমরি অ্যাড্রেসিং এবং অ্যাম্পারসেন্ড এর কিচ্ছাকাহিনী থেকে কিছু একটা বুঝাতে সক্ষম হয়েছি। ধইন্যাপাতা

Sunday, August 21, 2016

ডাটা স্ট্রাকচার - ৫ঃ স্ট্যাক

তোমার বাসায় সাতটি চেয়ার আছে। প্রথমে একটি চেয়ার রাখলে, তার উপর দ্বিতীয় চেয়ারটি, তারপর তৃতীয় চেয়ারটি এবং তারপর  চতুর্থ চেয়ার এরপর যথাক্রমে পঞ্চম , ষষ্ঠ এবং সপ্তম! অতঃপর চেয়ারের একটি স্তুপ তৈরী হল। এখন তোমাকে যদি চেয়ারগুলো স্তুপ থেকে আলাদা করতে বলা হয়  তাহলে তুমি  কি করবে? তোমাকে নিশ্চয়ই প্রথমে সাত নাম্বার চেয়ারটা তুলতে হবে তারপর ছয় নাম্বার তারপর পাঁচ নাম্বার  নাম্বার এভাবে সবশেষে এক নাম্বারটা তুলতে হবে। লক্ষ্য করবে  তুমি যে  ১ নাম্বার চেয়ারটি  প্রথমে রেখেছিলে তা তুলতে হল শেষে এবং ৭ নাম্বার চেয়ারটি শেষে দিলেন তা তুলতে হলো প্রথমে। এখানে চেয়ারের স্তুপ এক ধরনের স্ট্যাক। এইতো গেলো থিওরিটিকাল কনসেপ্ট। প্রোগ্রামিং এ  ব্যাপারটা ঠিক একইরকম। 

প্রোগ্রামিং এ আমরা নানান ধরনের ডেটা নিয়ে খেলা করি। ভিবিন্ন উপায়ে আমরা ডেটা রাখতে পারি। স্ট্যাক হল ডেটা রাখার এমনই এক ধরনের উপায়। এই উপায়ে ডেটা গুলো এমনভাবে রাখা হয় বা সাজানো থাকে যাতে পুরোপুরি উপরে বর্ণিত স্ট্যাক পদ্ধতি মেন্টেন করে। মানে প্রথমে যে ডেটা রাখলাম তা শেষে পাবো এবং শেষে যে ডেটা দিলাম তা আগে পাবো। এটাকে সংক্ষেপে বলা হয় FIFO বা ফার্স্ট ইন লাস্ট আউট।

ডেটা আমরা অ্যারে বা লিঙ্ক লিস্ট যেখানেই রাখিনা কেন এমন পদ্ধতি মেন্টেন করবো যাতে স্ট্যাকের নিয়ম অনুযায়ী আমরা ডেটাগুলো পাই। স্ট্যাক পদ্ধতিতে ডেটা রাখাকে বলা হয় Push এবং ডেটা বের করে নিয়ে আসাকে বলা হয় Pop


মুল তত্ত্বঃ  ডেটা ইন্সার্ট করার সময় সর্বশেষ ডেটার ইন্ডেক্স ট্রেস করে রাখবো। সেই ইন্ডেক্সকে বাড়িয়ে কমিয়ে আমরা প্রবেশ করাবো কিম্বা বের করে নিয়ে আসবো। আমাদের ক্ষেত্রে সেই ইন্ডেক্সটার নাম হবে top. যেহেতু প্রথমে অ্যারেতে কোন ডেটা থাকবেনা তাই প্রথমে top = -1 হবে। 


 Push Algorithm:  
 1. Initialize top with -1 and create array stack[MAX]   
 2. Insert data in array and increase the value of top   
 3. Continue 2 until array is not is not full   
 4. If array is full then exit   

 Pop Algorithm:   
 1. Return stack[top] and decrease the top  
 2. Continue 1 until stack is not empty   
 3. If stack is empty then exit   

Pseudo code:
 void push(int data)  
 {  
   top++;  
   if(top==MAX)  
   {  
     printf("Stack is full: ");  
     return sizeOfStack()-1;  
   }  
   stack[top] = data;  
 }  

 int pop()  
 {  
   if(top == -1)  
   {  
     printf("Stack is empty: ");  
     return sizeOfStack();  
   }  
   return stack[top--];  
 }  

ডাটা স্ট্রাকচার - ৬ঃ কিউ

Queue অন্যন্য ডাটা স্ট্রাকচারের মতই একটি ডাটা স্ট্রাকচার। আমরা আদের দৈনন্দিন জীবনে এটা প্রায়ই লক্ষ করি। যেমন,  বিদ্যুত বিল দিতে গেলে লাইনে দাঁড়িয়ে দিতে হয় সেটা একটা কিউ; ডিজিটাল ওয়ার্ল্ডে গেলে লাইনে দাঁড়িয়ে ঢুকতে হয়; ব্যাংক থেকে টাকা তুলতে গেলে কিম্বা টাকা জমা দিতে গেলে সেখানেও লাইনে দাড়াতে হয় আবার ঢাকা শহরে পুটপাতেও মাঝে মাঝে হাটতে গেলে কিউ তৈরি হয়!  মানে আমাদের প্রচলিত জীবন ব্যাবস্থার সর্বক্ষেত্রে রয়েছে কিউ এর ব্যাবহার! 
চিত্রঃ কিউ
প্রোগ্রামিং এ কিউ পদ্ধতিতেও ডেটা রাখা যায়। এ পদ্ধতিতে ডেটা রাখলে আগে আসলে আগে পাবেন ভিত্তিতে আমরা যেকোন ডেটা তুলে নিয়ে আসতে পারি। এজন্য একে কিউ বলা হয়। আমরা এখানে কিউ পদ্ধতিতে ডেটা রাখবো। ডেটা স্টোরেজ হিসেবে ব্যাবহার করবো অ্যারে।  এখন আমরা সি দিয়ে কিউ ইমপ্লিমেন্ট করার চেষ্টা করবো- 

মুল কনসেপ্টঃ আমরা জানি যেকোন কিউ এর ই সামনে এবং পেছন দুইটা পার্ট থাকে। কিউ এর পেছন থেকে দিক থেকে প্রবেশ করে এবং সামনের দিক থেকে কিউ থেকে বের হয়ে যায়। আমরা অ্যারেতে ডেটা রাখার সময় একইসাথে অ্যারের সামনে এবং পেছনের ইন্ডেক্সটা ট্রেস করে রাখবো। পেছনের ইন্ডেক্সটা ব্যাবহার করবো ডেটা প্রবেশ করানোর জন্য আর সামনের ইন্ডেক্স ব্যাবহার করবো বের করে নেওয়ার জন্য, ঠিক বাস্তব জীবনের কিউ যেভাবে কাজ করে। নীচের চিত্রে খেয়াল করো-  


চিত্রে দেখা যাচ্ছে সবার আগে 37 ইনপুট দেওয়া হল এবং সেটা সবার আগে রিমোভ হয়ে যাচ্ছে। ডেটা প্রবেশ করানোকে কিউ এর ভাষায় বলা হয় enqueue আর ডেটা বের করে আনাকে কিউ এর ভাষায় বলা হয় dequeue. 

Algorithm: 
 Enqueue Algorithm:  
 1. Create queue[MAX] and Set rear and front to -1 as there is nothing in the queue   
 2. enqueue data and increase front by 1   
 3. increase rear by 1   
 4. Continue 2 until queue is not full.   

 Dequeue Algorithm:   
 1. return queue[front]   
 2. decrease front by 1   
 3. continue 1 and 2 until queue is not empty   

Pseudocode:
 int enqueue(int data)  
 {  
   if (rear == MAX - 1)  
   {  
     printf("Queue is Full \n");  
     return;  
   }  
   if (rear == - 1)  
     front = 0;  
   rear = rear+1;  
   queue[rear] = data;  
 }  

 int dequeue()  
 {  
   if(front> rear)  
   {  
     printf("Queue is empty\n");  
     return 0;  
   }  
   return queue[front++];  
 }  

ডাটা স্ট্রাকচার - ৯ঃ বাইনারি সার্চ ট্রি

বাইনারি সার্চ ট্রিঃ বাইনারি সার্চ ট্রি এমন বিশেষ ধরনের ট্রি যেখানে প্রতিটা নোডের লেফট চাইল্ড ওই নোডের চেয়ে ছোট হবে এবং রাইট চাইল্ড ঐ নোডের চেয়ে বড় হবে। নীচের চিত্রে খেয়াল করো- 


ইমপ্লিমেন্টেশনঃ বাইনারি ট্রিতে আমরা ডেটা হিসেবে কিছু ইন্টেজার রাখবো-

 Algorithm of BST insert   
 1. Check the root is null or not. If the root is null then it will be the node   
 2. If root is not null then find out its parent on the basis of BST. Make sure that no node is overlapped   

Pseudo Code:
 Node *bstInsert(Node *root, Node *node)  
 {  
   Node *parentNode, *currentNode;  
   if(root == NULL)  
   {  
     root = node;  
   }  
   currentNode = root;  
   while(currentNode!= NULL)  
   {  
     parentNode = currentNode;  
     if(node->data<currentNode->data)  
     {  
       currentNode = currentNode->left;  
     }  
     else  
     {  
       currentNode = currentNode->right;  
     }  
   }  
   if(node->data<parentNode->data)  
   {  
     addLeftChild(parentNode, node);  
   }  
   else  
   {  
     addRightChild(parentNode, node);  
   }  
   return root;  
 }  

ডাটা স্ট্রাকচার - ৮ঃ বাইনারি ট্রি ইমপ্লিমেন্টেশন

এই পর্বে আমরা দেখবো কিভাবে ট্রি আকারে ডেটা স্টোর করা যায়। ইমপ্লিমেন্টেশনের সুবিধার্থে আমরা কোন নোডেই দুইটার বেশী চাইল্ড রাখবোনা। মানে বাইনারি ট্রি নিয়ে কাজ করবো। আর ডেটা হিসেবে রাখবো ইন্টেজার। 


 Algorithm:   
 1. Create node data type which is able to hold two the addresses of another two nodes and an integer   
 2. Create a node variable and put the necessary data in it.   
 3. Add left child of a particular node   
 4. Add right child of a particular node   
 5. Do 2, 3, 4 as much as you want to insert data   

Pseudo code
 //Create node data type 
struct Node  
 {  
   int data;  
   struct Node *left;  
   struct Node *right;  
 };  

 Node *createNode(int item)  
 {  
   Node *newNode = (Node*)malloc(sizeof(Node));  
   if(newNode == NULL)  
   {  
     printf("Error! Couldn't create new node\n");  
     exit(1);  
   }  
   newNode->data = item;  
   newNode->left = NULL;  
   newNode->right = NULL;  
   return newNode;  
 }  

 void addLeftChild(Node *node, Node *child)  
 {   
   node->left = child;  
 }  

 void addRightChild(Node *node, Node *child)  
 {  
   node->right = child;  
 }  

Saturday, August 20, 2016

ডাটা স্ট্রাকচার - ৭ঃ ট্রি টার্মিনোলজি

ট্রি ডেটা স্ট্রাকচার হল ডেটা স্টোর করার আরেকটি কনসেপ্ট। এই পদ্ধতিতে ডেটাগুলোকে এমনভাবে স্টোর করা হয় যার ভিজুয়ালাইজেশন অনেকটা ট্রি এর মত। নীচের চিত্রে খেয়াল করো। আমরা এর আগে দেখেছি যে এক নোড থেকে আরেক নোডে যেতে একটি মাত্র পথ ব্যাবহার করা যেতো এখানে দেখা যাচ্ছে এক নোড থেকে আরেক নোডে যেতে একাধিক পথ পাওয়া যায়। একে নন লিনিয়ার ডেটা স্ট্রাকচার বলে। নীচের চিত্রে খেয়াল করলেই ব্যাপারগুলো পরিষ্কার হয়ে যাবে- 

ট্রি এর কিছু গুরুত্বপুর্ন টার্মঃ 

১। মুল নোড (Root node): যেকোন ট্রি এর সবচেয়ে উপরের নোডটাই হল রুট নোড। যেমন, উপরের ট্রি ক্ষেত্রে রুট নোড হল- 10

২। এজ(Edge): দুটি নোডের মধ্যবর্তী সংযোগকে এজ বলা হয়। প্রত্যেকটি ট্রি'র n-1 লিঙ্ক থাকে! যেখানে n হল মোট নোড সংখ্যা! 

৩। প্যারেন্ট এবং চিলড্রেন(Parent and Children): যে নোড থেকে অন্য নোডের দিকে লিঙ্ক করা থাকে তাকে ওই নোডগুলোর প্যারেন্ট বলে। যেমন , 10 হল 20 ও 30 এর প্যারেন্ট নোড। একইভাবে 20, 30 হল 10 এর চিলড্রেন  

৪। সিবলিংস (Siblings): একই প্যারেন্ট যুক্ত নোডগুলোর একে অপরকে সিবলিংস বলে। যেমন, 20 ও 30 হলো পরস্পর পরস্পরের সিবলিংস। 

৫। লিফ নোড (Leaf Node): যে নোডের কোন চিলড্রেন থাকেনা তাদেরকে লিফ নোড বলে। চিত্রে 30, 40, 50 হল লিফ নোড 

৬। অ্যানসেস্টর (Ancestor): রুট নোড থেকে কোন নোডে আসতে যতগুলো নোড অতিক্রম করতে হয় তাদের প্রত্যেককেই ওই নোডের অ্যানসেস্টর বলে। বাংলায় যাকে বলা হয় পূর্বপুরুষ। 
যেমন, 40 এর অ্যানসেস্টর হল 10, 20 , 40
30 এর অ্যানসেস্টর হল- 10, 30  

লক্ষনীয়ঃ প্রত্যেকে আবার নিজেই নিজের নিজের অ্যানসেস্টর! নিজেকে বাদ দিয়ে যে অ্যানসেস্টর হয় তাকে proper ancestor বলে।
যেমনঃ Ancestor of 10: {10, 20}
proper ancestor of 40: {10}

৭। Descendant( বংশধর): কোন নোড থেকে লিফ নোড পর্যন্ত যেতে যতগুলো নোড অতিক্রম করতে হয় তাদের প্রত্যেক্যে ডিসচেন্ডেন্ট বা বংশধর বলে। বাংলায় যাকে বলে- সন্তান-সন্ততি/নাতি-পুতি :|  
10 এর ডিসচেন্ডেন্টঃ 10, 20, 40 

৮।  Degree of Node: কোন নোডের ডিগ্রি হল ওই নোড থেকে যাওয়া মোট সাব- ট্রি'র সংখ্যা! 
যেমন 10 এর সাব ট্রি 20 ও 30 সুতরাং  20 এর ডিগ্রি- 30, 40
এভাবে-
Degree of 10: 2
Degree of 20: 2
Degree of 30: 0

৯। Height of a Node: লিফ নোড থেকে কোন নির্দিষ্ট নোড পর্যন্ত সর্বাধিক লম্বা পথে যে পরিমান লিঙ্ক বা এজ পাওয়া যায় তাকে সে নোডের উচ্চতা বা height বলে। 
Height of 10: 2
Height of 20: 1
Height of 30: 0
Height of 40: 0

৯। Level a Tree (লেবেল): রুট নোডকে বলা হয় লেভেল ০ নোড। রুট নোডের চাইল্ডগুলোকে বলা হয় লেভেল ১ নোড। লেভেল ১ এর চাইল্ডগুলোকে বলা হয় লেভেল ২ নোড। এভাবে নোডগুলোর লেভেলিং হয়। 
Level 0: 10
Level 1: 20, 30
Level 2: 40, 50

১০। Depth of a Node: রুট নোড থেকে ঐ নোড পর্যন্ত যতগুলো লিঙ্ক থাকে সে লিঙ্কের মোট সংখ্যাকে ওই নোডের Depth বলে। যেমন,
Depth of A: 0
Depth of B: 1
Depth of F: 2
Depth of H: 3

***বাইনারি ট্রিঃ  ট্রি অনেক ধরনের হতে পারে। কম্পিউটার প্রোগ্রামিং এ সবচেয়ে বেশী আলোচনা হয় বাইনারি ট্রি নিয়ে। এই বাইনারি ট্রি দিয়েই বেশ কিছু অ্যালগরিদম আছে। বাইনারি ট্রি হল এমন এক ধরনের ট্রি যেখানে প্রতিটা নোডের চাইল্ড দুইটার বেশী হয়না। অথ্যাৎ, প্রতিটা নোডের চাইল্ড সংখ্যা ০, ১, ২ এর মধ্যেই সীমাবদ্ধ। বাইনারি ট্রি 

ফুল বাইনারি ট্রিঃ যেসব ট্রি  এর প্রতিটা নোডের দুইটা করে চাইল্ড থাকে তাকে ফুল বাইনারি ট্রি বলে। 


২। কমপ্লিট বাইনারি ট্রিঃ যেসব নোড ফুল বাইনারি ট্রি না কিন্তু নোডগুলো বাম পাশ থেকে ফিলাপ হয়ে আসে তাকে কমপ্লিট বাইনারি ট্রি বলে।