Sunday, June 21, 2026

Subline Text for Competitive Programming

Step 1: Install MinGW 

Step 2: Add to the environment variable 

Step 2: 

  • Open Sublime Text editor and then go to Tools > Build System > New Build System.
  • Paste the following code in the file and save it.
  • Name the file “CP.sublime-build“ and save it to this location- C:\Users\UserName\AppData\Roaming\Sublime Text 3\Packages\User
{
    "cmd": ["g++.exe", "-std=c++17", "${file}",
            "-o", "${file_base_name}.exe",
            "&&", "${file_base_name}.exe<inputf.in>outputf.out"],
    "shell":true,
    "working_dir":"$file_path",
    "selector":"source.cpp"
}

3. Create three new files as shown below and make sure all of them are in the same folder.

  • file.cpp: The file for writing the code.
  • inputf.in: The file where we will be giving the input.
  • outputf.out: The file where the output will be displayed.
Step - 4: 
  • Select View > Layout > Columns : 3. This will create three columns in the workspace. Move the three files into three columns.
  • Select View > Groups > Max Columns : 2.
  • Select the build system we just created from Tools > Build System > CP.
Step 5: Build using Ctr + B

You can create separate build system for any other programming language in the same way- I.E- Python 

{ "cmd": ["python", "-u", "$file", "<", "inputf.in", ">", "outputf.out"], "shell": true, "working_dir": "$file_path", "selector": "source.python" }

Save as Python.sublime-build to the same location and select build system as Python. Goto Tools-> BuildSystem->Python


Understanding AI Agents, Models, Tools, MCP, and Cost

🚀 Understanding AI Agents, Models, Tools, MCP & Cost

When I first started using Claude Code, Cursor, OpenCode, and GitHub Copilot, I had one question:

What exactly is an AI Agent?

The more I explored, the more I realized that people often mix together:

• AI Companies
• AI Assistants
• AI Models
• AI Agents
• Tools
• MCP

Here's the simplest way to think about modern AI systems:

User -> Agent -> Model -> Tools

1. User → Defines the Goal

Examples:

  • Fix the failing test
  • Create a Jira ticket
  • Deploy to Dev
  • Summarize a Slack thread

The user provides intent.


2. Model → The Brain

Examples:

  • GPT-5
  • Claude Sonnet / Opus
  • Gemini
  • DeepSeek
  • Llama

Models can:

✅ Reason
✅ Plan
✅ Explain
✅ Generate code

Models cannot:

❌ Run tests
❌ Read your files directly
❌ Create PRs
❌ Send Slack messages

A model can think.

A model cannot act.


3. Tools → The Hands

Examples:

  • Git
  • GitHub
  • Docker
  • .NET CLI
  • Jira
  • Slack

Tools execute actions.

They don't reason.


4. Agent → The Orchestrator

Examples:

  • Claude Code
  • Cursor Agent
  • OpenCode
  • GitHub Copilot Agent
  • Cline

An agent sits between the model and the tools.

Its job is to:

• Gather context
• Call the model
• Execute tools
• Verify results
• Manage workflows


The Biggest Misconception is many people think: "The model fixed my code."

What actually happened:

  1. Agent runs tests
  2. Agent sends results to the model
  3. Model analyzes the failure
  4. Agent collects more context
  5. Model proposes a fix
  6. Agent applies the change
  7. Agent reruns tests

The model decides and the agent executes.


The Real Superpower: Context Management

In a repository with:

  • 50,000 files
  • Millions of lines of code

You can't send everything to the model.

A great agent knows:

• Which files matter
• Which logs matter
• Which tests matter
• Which dependencies matter

The quality of AI output is directly tied to the quality of context.


MCP in One Sentence: MCP (Model Context Protocol) is a standard way for agents to interact with tools. Instead of building custom integrations for every service, agents can use a common interface for:

  • GitHub
  • Jira
  • Slack
  • Databases
  • Internal systems


OpenCode vs Claude Code: 

OpenCode

OpenCode -> Any Model -> Tools

Switch between Claude, GPT, Gemini, DeepSeek, OpenRouter, or local models.

Claude Code

Claude Code -> Claude Models -> Tools

A more integrated experience with less setup.


Where AI Costs Come From

The expensive part isn't dotnet test

The expensive part is:  Agent to Model communication

Every interaction consumes tokens, More context = more tokens = more cost.

A strong agent reduces cost by sending only the most relevant information instead of entire files, massive logs, and unrelated code.


In Summary

User   = Manager
Agent  = Operating System
Model  = CPU
Tools  = Peripherals

The manager defines the goal, The operating system coordinates the work, The CPU provides intelligence, The peripherals perform actions.


The future of AI isn't just smarter models.

It's:Smarter Models + Better Agents + Better Tools + Better Context Management

That's where the biggest productivity gains will come from.

Thursday, October 10, 2019

ডাটা স্ট্রাকচার - ১১ঃ হিপসর্ট

হিপ পদ্ধতি অবলম্বন করে যে ধরনের সর্ট করা হয় তাকেই হিপ সর্ট বলে। আমরা জানি হিপে রুট নোডটা থাকে সবচেয়ে বড়। হিপ সর্টে সেই রুট নোডটাকে সবার শেষের নোডের সাথে সোয়াপ করা হয়। তারপর শেষের নোডটা বাদ দিয়ে পুরো ট্রি টাকে আবার হিপে রুপান্তর করা হয়। এভাবে সোয়াপ এবং হিপে রুপান্তরের এক পর্যায়ে পুরো ট্রি টা সর্ট হয়ে যায়। নীচের সিমুলেশনটা খেয়াল করো-


সোয়াপ করার পর প্রতিবার আমরা শেষ থেকে একটা করে নোড বাদ দিয়ে বাকি অংশটাকে হিপিফাই করতেছি। এভাবে একটা পর্যায়ে গিয়ে পুরো ট্রি টাই সর্ট হয়ে যায়। কোডে রুপান্তর আরো সোজা-

 void heapSort(int heap[], int heapSize)  
 {  
   int i, temp;  
   buildMaxHeap(heap, heapSize); //Building heap  
   for(i = heapSize; i>1; i--)  
   {  
     temp = heap[1];  
     heap[1] = heap[heapSize];  
     heap[heapSize] = temp;  
     heapSize--;  
     maxHefipy(heap, heapSize, 1);  
   }  
 }  

Wednesday, October 9, 2019

ডাটা স্ট্রাকচার - ১০ঃ হিপ


হিপঃ হিপ হলো একটি কমপ্লিট বাইনারি ট্রি যে ট্রি এর প্রতিটি নোড তার চাইল্ড নোডের চেয়ে বড় বা ছোট থাকে থাকে। যদি বড় থাকে তাকে ম্যাক্স হিপ বলে আর যদি ছোট থাকে তাকে মিন হিপ বলে। এখানে আমরা শুধু ম্যাক্স হিপ নিয়েই ত্যানা পেঁচাবো। উপরে একটি ফিগার দেওয়া হলো-

একটি ট্রি কে অ্যারেতে স্টোর করার একমাত্র অসুবিধা হল কার চাইল্ড কে হবে তা আইডেন্টিফাই করতে না পারা। হিপ যেহেতু একটা কমপ্লিট বাইনারি ট্রি সে সুবিধা প্রয়োগ করে আমরা হিপকে একটা অ্যারেতে স্টোর করতে পারি এবং খুব সুন্দরভাবেই কোন ইন্ডেক্সের চাইল্ড কে তা বের করে আনতে পারি। উপরের ট্রি কেই অ্যারে আকারে লিখলাম ০ নাম্বার ইন্ডেক্স বাদ দিয়ে। খেয়াল করো।

এখন কোন ইন্ডেক্সের চাইল্ড কে হবে সেটি বের করতে পারলেই আমাদের সমস্যা শেষ। নীচের স্টেটমেন্টগুলো লক্ষ্য করো এবং অ্যারের ইন্ডেক্সগুলোর সাথে মিলিয়ে দেখো-

heap[0] = 0
heap[1] = 90
heap[2] = 85
heap[3] = 80
heap[2*2] = 70 // Left Child of 2
heap[2*2+1] = 60 //Right Child of 2
heap[3*3] = 55 //Left child of 3
heap[3*3+1] = 50 //Right Child of 3

সো, এখান থেকে এই জিনিসট স্পষ্ট যে কোন একটি ইন্ডেক্স যদি হয় i তাহলে তার লেফট চাইল্ড এর ইন্ডেক্স হবে i*i এবং রাইট চাইল্ড এর ইন্ডেক্স হবে i*i+1 । আবার তার প্যারেন্ট কে তার জন্য i কে দুই দিয়ে ইন্টেজার ডিভিশন করলেই কাজ শেষ । সো, এই কথাগুলোকেই কোডে আকারে লিখে ফেলি-

 int left(int i)  
 {  
   return 2*i;  
 }  
 int right(int i)  
 {  
   return (2*i)+1;  
 }  
 int parent(int i)  
 {  
   return i/2;  
 }  

নির্দিষ্ট কিছু ডেটাকে হিপ আকারে রাখার অ্যালগরিদমঃ

1. Find the left child and right child particular index
2. Find the biggest index between left, right and the particular index. Then swap the value of the biggest index and the particular index.
3. Do it until the biggest index is found in the left or right child


Pseudo Code:
 void maxHefipy(int heap[], int heapSize, int i)  
 {  
   int l, r, largest;  
   l = left(i);  
   r = right(i);  
   if(l<=heapSize && heap[l]>heap[i])  
   {  
     largest = l;  
   }  
   else  
   {  
     largest = i;  
   }  
   if(r<=heapSize && heap[r]>heap[largest])  
   {  
     largest = r;  
   }  
   if(largest!= i)  
   {  
     int temp = heap[i];  
     heap[i] = heap[largest];  
     heap[largest] = temp;  
     maxHefipy(heap, heapSize, largest);  // maxHefipy again from the largest index
   }  
 }  

একটি নোডের সবগুলো সাবট্রি যদি হিপ হয় সেক্ষেত্রে ওই নোডকে একবার কল করলেই এই অ্যালগরিদম দিয়ে পুরোপুরি হিপিফাই করা যাবে। উপরের চিত্রটি ভালোভাবে খেয়াল করলে বুঝতে পারবে।

কিন্তু ট্রি তে ডেটা যদি অন্যভাবে সাজানো থাকে তাহলে কিন্তু উপরের মত কাজ করবেনা। নীচের চিত্রে খেয়াল করো একবার কল করার পরই রিকার্সিভ কল বন্ধ হয়ে যাচ্ছে। কারন ৪ দিয়ে আর কল করা যাচ্ছেনা।


এই পরিস্থিতিতে maxHeapify() কে একাধিকবার কল করতে হবে। উপরের অ্যালগরিদমটাই N/2 বার কল করলেই পুরো ট্রি টা ১০০% হিপিফাই হয়ে যাবে। হিপিফাই করবো N/2 তম ইন্ডেক্স থেকে শূরু করে প্রথম ইন্ডেক্স পর্যন্ত। উপরের ট্রি এর ক্ষেত্রে এটা হবে 5/2 = 2 (ইন্টেজার ডিভিশন)। তো বুঝতেই পারছো এখানে আমাদের লুপ ব্যাবহার করতে হবে।

 void createMaxHeap(int heap[], int heapSize)  
 {  
   int i;  
   for(i = heapSize/2; i>=1; i--)  
   {  
     maxHefipy(heap, heapSize, i);  
   }  
 }  

নীচের সিমুলেশনটা খেয়াল করো-

কি! ক্লিয়ার না কোন ভেজাল আছে? ভেজাল থাকে কমেন্ট করে জানাইতে পারো। 

Thursday, October 3, 2019

ডাটা স্ট্রাকচার - ৪ঃ ডবলি লিংক লিস্ট

এর আগে আমরা যে লিংক লিস্ট নিয়ে কাজ করেছি সেখানে শুধু একদিক থেকে যাওয়া যায়। দুই দিক থেকে যাওয়া যায়না। যেমন ধরো, আমি ১০ থেকে শুরু করে লিস্টের ৫০ পর্যন্ত গেলাম। আবার ৫০ থেক শুরু করে যদি ১০ পর্যন্ত আসতে চাই তাহলে সিংগ লিংক লিস্টে সেটা সম্ভব না।


অথ্যাৎ, দ্বিমুখী না। দ্বিমুখী না হওয়ার কারন একটাই কারন আমরা প্রতিটা নোডে শুধু নেক্সট নোডেরই অ্যাড্রেস রাখি, এর আগে যে থাকবে সে  অ্যাড্রেসটা ধরে রাখিনা। ডবলি লিংক লিস্ট এমন ধরনের লিংক লিস্ট যেখানে প্রতিটা নোড একইসাথে নেক্সট জনের অ্যাড্রেস ধরে রাখে এবং প্রিভিয়াস জনের অ্যাড্রেসও ধরে রাখে। চিত্রে প্রথমটা সিংগলি লিঙ্ক লিস্ট পরেরটি ডাবলি লিঙ্ক লিস্ট। ডবলি লিঙ্ক লিস্টে আমরা দুই দিক থেকেই আসা যাওয়া করতে পারবো। 

ইমপ্লিমেন্টেশনঃ ইমপ্লিমেন্টেশন আগের মতই শুধু নোড তৈরী করার সময় Previous নোড রাখার জন্য একটা এক্সট্রা পয়েন্টার রাখতে হবে একইভাবে ডেটা ইন্সার্ট করার সময় Next Node এর পাশাপাশি Previous Node কে  হবে তা নির্দিষ্ট করে দিতে হবে।  বাকি সব আগের মতই। আমরা লিংক লিস্টের কোডটাই মডিফাই করে ডবলি লিংক লিস্ট আকারে লিখতে পারি-

 void inserEnd(int value)  
 {  
   if(sefuda == NULL)  
   {  
     person = (node*)malloc(sizeof(node));  
     person->data = value;  
     person->prev = NULL;  
     person->next = NULL;  
     sefuda = person;  
     current = sefuda;  
   }  
   else  
   {  
     person->next = (node*)malloc(sizeof(node));  
     person = person->next;  
     person->data = value;  
     person->prev = current;  
     person->next = NULL;  
     current = person;  
   }  
 }  


Thursday, August 22, 2019

ডাটা স্ট্রাকচার - ৬ঃ বাইনারি ট্রি ট্রাভার্সাল

এই পর্বে আমরা শিখবো কিভাবে একটা বাইনারি ট্রি এর মধ্যে ট্রাভার্স করতে হয়। একটা ডাটা স্ট্রাকচারের ডেটাগুলো অ্যাক্সেস করার ক্ষেত্রে ট্রাভার্সাল জিনিসটা অনেক বেশী গুরুত্বপুর্ন। বাইনারি ট্রিতে ৩ ভাবে ট্রাভার্সাল চালানো যায়-


১। প্রি অর্ডার(Pre Order): প্রথমে রুট, তারপর লেফট, তারপর রাইটে যেতে হয়- Root->Left->Right-
 2, 7, 1, 6, 5, 10, 9, 8, 3, 4

২। ইন অর্ডার(In Order):  প্রথমে লেফট, তারপর রুট তারপর রাইট- Left->Root->Right:
1, 7,  5, 6, 10, 2, 9, 3, 8, 4

৩। পোস্ট অর্ডার(Post Order): প্রথমে লেফট তারপর রাইট এবং সবশেষে রুট- Left->Right->Root :
1, 5, 10, 6, 7, 3, 4, 8, 9, 2


ব্যাপারটা কিন্তু একদম সহজ, ইনঅর্ডারের ক্ষেত্রে আমরা সিমুলেট করে দেখি- বোঝার সুবিদার্থে আমরা মার্কার নামক একটা শব্দ ব্যাবহার করবো। ভিবিন্ন নোডে মুভ করবে, যখন যেখানে থাকবে সেটাকে আমরা ওই সময়ে রুট হিসেবে চিন্তা করবো যদি সেই নোডের চাইল্ড থাকে। 

ট্রাভার্সালের একদম শুরুতে মার্কার থাকবে দুই নোড- ২ তে। তার মানে এই মুহুর্তে রুট হল ২। কিন্তু নিয়মুনাযায়ী প্রথমে নিতে হবে লেফট কে। তাই মার্কার এখন লেফট এ চলে যাবে তা হল ৭। ৭ এরদুটো চাইল্ড আছে তার মানে ৭ হল তাদের রুট।  আবার ৭ এর আবার লেফট চাইল্ড আছে,  তাই বামে মুভ করবো আর তা হল- ১। মার্কার এখন ১ এ আছে। ১ এর কোন চাইল্ড নাই তাই এটাকে আমরা নিয়ে নিবো। তারপর এই নোডের জন্য যে, রুট তাকে নিয়ে নিবো। আর সেটা হল ৭। ৭ এর লেফট এবং রুট নেওয়া হল। বাকি থাকলো রাইট। মার্কার এখন ৭ এ রাইট চাইল্ডে যাবো। কিন্তু রাইট চাইল্ডের আবার লেফট চাইল্ড আছে তা হল ৬।  মার্কার এখন ৬ এ আছে। কিন্তু ৬ এর যেহেতু লেফট চাইল্ড আছে আমরা লেফটে চলে যাবো। তার মানে আমাদের মার্কার এখন ৫ এ। লেফট নিলাম এখন ৫ এর রুট নিবো আর তা হলো ৬। রুট নিলাম এখন বাকি আছে রাইট তা হলো ১০ । খেয়াল করো ২ এর লেফট নেওয়া হয়ে গেছে। এখন রুট নিবো তা হলো ২। লেফট, রুট নেওয়া হয়ে গেছে এখন বাকি আছে রাইট।

মার্কার এখন ৯ এ আছে। ৯ এর যেহেতু কোন লেফট নাই তাই লেফট থেকে নেওয়ার কিছু নাই। লেফট গেলো এখন নিবো রুট আর তা হল ৯। বাকি আছে রাইট। ৯ এর রাইটে আছে ৮। আমাদের মার্কার এখন ৮ এ ।  ৮ এর লেফট চাইল্ড ৩। মার্কার এখন ৩ এ। ৩ এর যেহেতু কোন চাইল্ড নাই ৩ ই হল ৮ এর লেফট। লেফট গেলো এখন বাকি আছে রুট। রুট হল ৮ । এখন বাকি আছে রাইট মার্কার এখন ৪ এ! ৪ কে নেই।

এভাবে বাকিগুলো নিজে নিজে সিমুলেট করে দেখো।


ইমপ্লিমেন্টেশনঃ
রিকার্সন দিয়ে এই কাজটা খুব সহজেই করা যায়। কেউ চাইলে লুপ দিয়েও করতে পারে-

 void preOrder(Node *node)  
 {  
   printf("%d ", node->data);  //print root
   if(node->left!= NULL){  //if there is any left child go to left 
     preOrder(node->left);  
   }  
   if(node->right!= NULL){  //if there is any right child go to right 
     preOrder(node->right);  
   }  
 }  

 void inOrder(Node *node)  
 {  
   if(node->left!= NULL){  //if there is any left child go to left 
     inOrder(node->left);  
   }  
   printf("%d ", node->data);  //print the root 
   if(node->right!= NULL){  //if there is any right child go to right
     inOrder(node->right);  
   }  
 }  

 void postOrder(Node *node)  
 {  
   if(node->left!= NULL){  //if there is any left child go to left 
     postOrder(node->left);  
   }  
   if(node->right!= NULL){  //if there is any right child go to right 
     postOrder(node->right);  
   }  
   printf("%d ", node->data);  //print the root 
 }  

Friday, June 21, 2019

গ্রাফ থিওরি-৩ঃ ব্রেডথ ফার্স্ট সার্চের ব্যাবচ্ছেদ


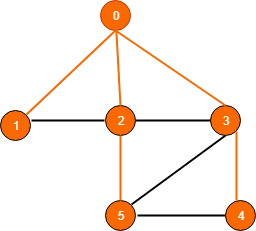
ওকে । আমরা গ্রাফ তৈরী করলাম, গ্রাফ ইনপুটও নিয়ে ফেললাম। খুব ভালো কথা। কিন্তু এটা দিয়ে করবোটা কি? কি করবো সেই ব্যপারটা সবার আগে নির্ধারন করে নিতে হবে। আমরা চাই ০ নাম্বার নোড থেকে বাকি সব নোডের দুরত্ব বের করবো। কিন্তু কোন দুরত্ব? দুরত্ব নির্ভর করে আমরা কোন  পথ দিয়ে যাচ্ছি তার উপর।

গ্রাফটা যেহেতু আনওয়েটেড সেহেতু সবগুলো এজ এর কস্ট সমান; ধরে নেই তা ১ ।  মানে হলো, ০ থেকে ১ এ যেতে যা, ০ থেকে ২ এ যেতে তা একইভাবে ২ থেকে ৩ এ যেতেও একই খরছ। এখন আমি যদি তোমাকে জিজ্ঞেস করি ০ থেকে ২ নাম্বার নোডে যেতে খরছ কত হবে? এখন খরছ কত হবে এটা নির্ভর করবে আমি কোন পথ দিয়ে যাচ্ছি। খেয়াল করো ০ থেকে ২ নাম্বার নোডে আসতে কিন্তু অনেকগুলো পথ আছে। আমরা পথ ও তাদের খরছের ছোটখাটো একটা হিসেব করে ফেলি-

পথ-১ঃ 0->1->2: 1+1 = 2
পথ-২ঃ 0->2: 1
পথ-৩ঃ 0->3->2: 2
পথ-৪ঃ 0->3->5->2: 1+1+1 = 3
পথ-৫ঃ 0->3->4->5->2: 1+1+1+1 = 4

দেখতেই পারছো শুধুমাত্র ২ তে আসার মোট পথ ৫ টা। আমরা সবচেয়ে ছোট পথটাই খুঁজে বের করবো। উপরের গ্রাফের ক্ষেত্রে ০->৩->২ বা কস্ট ২। আমরা সোর্স নোড থেকে প্রতিটা নোডের মিনিমাম কস্ট খুঁজে বের করবো।

শর্টেস্ট ডিস্টেন্ড বের করার অনেকগুলো অ্যালগরিদম আছে। তার মধ্যে একটা অ্যালগরিদম হল ব্রেডথ ফার্স্ট সার্চ। এই অ্যালগরিদম শুধুমাত্র আনওয়েটেড গ্রাফের ক্ষেত্রে কাজ করে। হোপফুলি ব্রেডথ ফার্স সার্চের কেন দরকার সে ব্যপারটা মোটামুটি ক্লিয়ার।

আমরা এখন দেখবো বিএফএস কিভাবে এই কাজটা করে-

প্রতিটা নোড থেকে তার এডজেসেন্ট নোডে ভিজিট করবো, কোন নোডে একবারের বেশী ভিজিট করা যাবেনা। 

০ যেহেতু আমাদের সোর্স নোড তাই এখান থকেই ট্রাভার্স শুরু করবো। তাইলে শুরু করে দেই-
  • ০ তে ভিজিট করলাম। এই মুহুর্তে গ্রাফের অবস্থা। সোর্স নোডের দুরত্ব- ০
  • ০ থেকে ১, ২, ৩ এ চলে গেলাম। সোর্স থেকে এদের দুরত্ব ০+১ = ১।  এই মুহুর্তে গ্রাফের অবস্থা- 
  • ১ থেকে ২ এ পথ আছে কিন্তু ২ অলরেডি ভিজিটেড। ২ থেকে ৩ এ পথ আছে কিন্তু ৩ অলরেডি ভিজিটেড। আমরা ২ থেকে ৫ এ চলে গেলাম। এরপর ৩ থেকে শুধুমাত্র ৪ এ যেতে পারবো। সোর্স থেকে ৫ এবং ৪ এর দুরত্ব- ১+১ = ২।  এই মুহুর্তে গ্রাফের অবস্থা- 
যে পথগুলো আমরা ভিজিট করিনাই সেই পথগুলো বাদ দিলে পুরো গ্রাফটা একটা ট্রি হয়ে যায়। এর মানে হলো কোন নোডেই যাওয়ার জন্য একটার বেশী পথ পাবেনা। যে পথ আছে সেটাই সোর্স নোড থেকে  সর্বনিন্ম পথ। আমি আনইউজড পথগুলো হাল্কা করে দিচ্ছি। খেয়াল করলেই বুঝতে পারবা-
এই কাজটা কোডে রূপান্তর করা একদমই সোজা। আমরা প্রতিটা নোড থেকে তার সংগলগ্ন নোডগুলোতে যাওয়ার চেষ্টা করবো। যদি যেতে পারি তাহলে সেই নোডটাকে ভিজিটেড মার্ক করে দিবো। কিন্তু কোন নোডের পর কোন নোডে কাজ করবো সেই সিকুয়েন্স মেন্টেন করার জন্য কিউ ডেটা স্ট্রাকচার ব্যবহার করবো। অথ্যাৎ, কিউ থেকে একটা একটা করে নোড নিয়ে আসবো এবং সে নোডের অ্যাডজেসেন্ট নোডগুলোতে ভিজিট করবো। ভিজিট করা নোডগুলোকে কিউ তে পুশ করবো। এই কাজটা করতে থাকবো কিউ খালি হওয়া পর্যন্ত। পুরো ব্যাপারটা আসলে এমন-

১। সোর্স নোডকে ভিজিটেড মার্ক করা এবং  কিউ তে পুশ করা
২। কিউ থেকে পপ করা
৩। পপ করা নোডের এডজেসেন্ট নোডগুলোতে ভিজিটেড মার্ক করা এবং সেগুলোকে কিউতে পুশ করা।
৪। ২, ৩ চলতে থাকবে যতক্ষণ না কিউ খালি হয়

সুডোকোডঃ
 create a queue Q   
 mark v as visited and put v into Q   
 while Q is non-empty   
   remove the head u of Q   
   mark all the neighbours as visited and enqueue all (unvisited) neighbours of u  
যেহেতু আমাদেরকাজ হলো সোর্স থেকে প্রতিটা নোডের ডিস্টেন্স বের করা সেহেতু কোন নোড ভিজিটেড হয়ে গেলে তার ডিস্টেন্সটা distance[] নামক একটা অ্যারেতে রাখবো।  সোর্সের ডিস্টেন্স যেহেতু ০ তাই distance[source] = 0 হবে। এভাবে বাকিগুলো।

পুরো ঘটনাকে যদি সিমুলেট করি -

স্টেপ- ১ঃ ০ তে ভিজিট করলাম। একে কিউ তে পুশ করি। distance[0] = 0

Queue- 0

স্টেপ- ২ঃ কিউ থেকে একটা আইটেম পপ করলে পাবো নোড ০ কে। ০ থেকে যাওয়া যায় ১, ২, ৩ এ। এই তিনটাকে ভিজিটেড হিসেবে মার্ক করি।
distance[1] = distance[0]+1, distance[2] = distance[0]+1, distance[3] = distance[0]+1
১, ২, ৩ কে কিউতে পুশ করি-

Queue: 1 2 3

স্টেপ- ৩ঃ কিউ কে পপ করলে ১ পাবো। ১ থেকে যাওয়া যায় ২ তে। কিন্তু ২ অলরেডি ভিজিটেড। তাই কিছুই করবোনা।

Queue: 2 3

স্টেপ- ৪ঃ কিউ থেকে আবার পপ করলে পাবো ২ । ২ থেকে ৩ ও ৫ যাওয়া যায়। কিন্তু ৩ যেহেতু অলরেডি ভিজিটেড আমরা শুধু ৫ এ ভিজিট করবো। distance[5] = distance[2]+1. ৫ কে কিউতে পাঠিয়ে দেই

Queue: 3 5

স্টেপ- ৫ঃ এবার পপ করলে ৩ কে পাবো । ৩ থেকে ৫ ও ৪ এ যাওয়া যায়। ৫ অলরেডি ভিজিটেড। আমরা শুধু ৪ এ যাবো। distance[4] = distance[3]+1.  ৪ কে কিউ তে পুশ করি

Queue: 5 4

স্টেপ- ৬ঃ আবার পপ করলে পাবো ৫ কে। ৫ এর এডজেসেন্ট নোড সব ভিজিটেড। তাই কিছু করবোনা।

Queue: 4 

স্টেপ- ৭ঃ ৪ কে পপ করি। ৪ থেকেও কোথাও যাওয়া যায়না।

Queue: 

স্টেপ- ৮ঃ কিউ ফাঁকা। কাজ শেষ। খেয়াল করো, আমরা কিন্তু distance অ্যারের ভিতর সবগুলো নোডের দুরত্ব পেয়ে গেছি।

বুঝতেই পারছো কোডে ইমপ্লিমেন্ট করার সময় একটা কিউ ডেটা স্ট্রাকচার লাগবে। তুমি চাইলে লাইব্রেরি ইউজ করতে পারো অথবা নিজেই বানাতে পারো। পুরো কোডটা প্রথমে নিজে ইমপ্লিমেন্ট করার চেষ্টা করো। তারপর নীচের কোডটা দেখো-
 while(!q.empty())  
   {  
     int u = q.front();  
     q.pop();  
     printf("%d ", u);  
     for(v = 0; v<g[u].size(); v++)  
     {  
       int adjecentNodeofU = g[u][v];  
       if(visited[adjecentNodeofU] == 0)  
       {  
         visited[adjecentNodeofU] = 1;  
         level[adjecentNodeofU] = level[u]+1;  
         q.push(adjecentNodeofU);  
       }  
     }  
     cout<<endl;  
   }  

পুরো কোড পাওয়া যাবে এখানেঃ
১। BFS using Adjacency Matrix
২। BFS using Adjacency List 

ওয়াইফাই থেকে ডেটা সেইভ রাখা আসলেই সম্ভব?


মোবাইল, ল্যাপটপ সহ সমস্ত ইলেক্ট্রিক ডিভাইস চার্জ করে পরবর্তীতে ব্যবহার করা যায়। এই জিনিসটাই আমাদের জীবন ব্যবস্থা কতটা সহজ করে ফেলছে তা কল্পনা করা যাবেনা। পাওয়ার ব্যাংক চার্জ করে মানুষ দুনিয়া ঘুরে। পাহাড় কিম্বা সাগরের মাঝখানে সব যায়গায় সচল থাকে ইলেক্ট্রিক ডিভাইস। ইলেক্ট্রিসিটি সংরক্ষণের এই পদ্ধতির আবিষ্কারককে সম্ভব হলে আমি নোবেল দিতাম। যাইহোক ইলেক্ট্রিক ডিভাইস নিয়ে কথা বলা আলোচ্য বিষয় না।

একজন সেলুলার নেটওয়ার্ক ইউজারের কাছে ওয়াইফাই কিম্বা ব্রডব্যান্ডের গুরুত্ব কতটা তা মোটামুটি সবাই জানি। যে জন্মের পর পরই ওয়াইফাই এর চেহারা দেখছে কিম্বা জীবনে কখনো মোবাইল ডেটা ব্যাবহার করার দরকার পড়েনাই তার কথা বাদই দিলাম; যদিও আমি মনে করিনা সেরকম প্রাণী বাংলাদেশে এখনো জন্ম নিয়েছে। আর যে প্রথম ওয়াইফাই এর চেহারা দেখছে তার কাছে এইটার অনুভূতি অনেকটা মানুষখোর বাঘের মত কিম্বা বিরিয়ানি খাদকের মত।  এখনো মনে পড়ে শুধু ওয়াইফাই এর জন্য বসুন্ধরায় গিয়ে কত কত সময় পার করছি।

যাইহোক, স্বাভাবিকভাবে প্রশ্ন আসবেই যদি এই ডেটা সংগ্রহ করে যদি বাসায় নিয়ে যাই তাহলে একই স্পিডে বিনা খরছে নেট ব্রাউজ করতে পারবো। এটা খুবই স্বাভাবিক এবং মজার একটা প্রশ্ন! এই প্রশ্নটা করার মানে হলো ইন্টারনেট কিভাবে কাজ করে এই ব্যপার সম্পর্কে তার আইডিয়া নাই। আমার তো ধারনা ৯০% ইন্টারনেট ইউজারই জানেনা আসলে এই জিনিসটা কিভাবে কাজ করে। কিন্তু আমাদের এমন একটা জাতি কেউ যখন সাহস করে কোন প্রশ্ন করে উত্তর নিজে জানি আর না জানি  পচাইতে পচাইতে রীতিমত প্রশ্নকর্তার প্যান্ট খুলে দেই। যাইহোক আমি নেটওয়ার্কিং এর ক্ষুদ্র জ্ঞানে  সবার কাছে সহজবোধ্য করে বুঝানোর চেষ্টা করবো আসলে ব্যাপারটা কি!

মনে করুন আপনার পিসির সাথে আপনার ফোন ডেটাকেবল দিয়ে কানেক্টেড। আপনি চাইলে আপনার পিসি দিয়ে ফোনের সব ডেটা দেখতে পাবেন। একইভাবে আপনার দুইটা পিসি যদি পরস্পর ক্যাবল দিয়ে কানেক্টেড হয় তাহলে এক পিসি থেকে অন্য পিসির সমস্ত ডেটা দেখতে পাবেন। ডেটা বলতে আমি বুঝাচ্ছি অডিও, ভিডিও, ছবি, অন্যন্য ডকুমেন্টস। আপনার একটা পিসি যদি উগান্ডা থাকে এবং একইভাবে ক্যাবল দিয়ে কানেক্টেড থাকে তাহলে আপনি চাইলে বাংলাদেশে বসেই ওই পিসিতে যা যা আছে সবই দেখতে পাবেন বা ট্রান্সফার করতে পারবেন । এভাবে যদি পৃথিবীর সবগুলো পিসি বা সার্ভারকে কানেক্ট করা যায় তাহলেই হয়ে যায় তাহলে আপনি পৃথিবীর সব পিসি কিম্বা সার্ভারে যা আছে তাই দেখতে পাবেন। এটাই  ইন্টারনেট। তার মানে এটা বুঝা গেলো ইন্টারনেট মানে হলো পৃথিবীর সব পিসি বা সার্ভারের কানেকশন।

মনে করুন আপনি ফেইসবুক ডটকমে ঢুকলেন! এত এত প্রোফাইল, ভিডিও, ছবি দেখতে পাচ্ছেন! এগুলোর কোনটাই আপনার পিসিতে নাই। তাহলে এগুলো কোথা থেকে আসছে? এগুলো সবই আসতেছে ফেইসবুকের ডেটা সেন্টার থেকে। তার মানে কি ব্যাপারটা এই দাঁড়ালো ফেইসবুকের ডেটা সেন্টারের সাথে আপনার পিসির কানেকশন আছে? হ্যাঁ! ঠিক ধরেছেন। আপনার পিসি ইন্টারনেটে কানেক্টেড থাকা মানে ফেইসবুকের সার্ভারের সাথেও কানেক্টেড। এখন কথা হলো পৃথিবীর সবগুলো পিসির সাথে কানেকশন কেমনে করলো? ভাভাগো ভাভা!

পৃথিবীতে যতগুলো দেশ আছে সবগুলো অপটিক্যাল ফাইবার দিয়ে কানেক্টেড। এই ক্যবলগুলো ডেটা ট্রান্সমিশন স্পিড খুবই  উচ্চমানের। ১০০ থেকে ১৫০ জিবিপিএস এর মত। এই ক্যাবলগুলো মুলত সাগরের তলদেশে বিছিয়ে দেওয়া হয়েছে। সেই ক্যাবলেরই একটা প্রান্ত প্রতিটি দেশেই আছে। এটাকে বলা হয় ল্যান্ডিং পয়েন্ট। বাংলাদেশে দুইটা ল্যান্ডিং পয়েন্ট আছে একটা হল কক্সবাজারে আরেকটা হল কুয়াকাটায়। পাশের দেশ মায়ানমারে আছে ৩টা, ইন্ডিয়ায় আছে বেশ কয়েকটা। পুরো দেশের অন্যান্য সার্ভার বা পিসি এই ল্যান্ডিং পয়েন্টের সাথে কানেক্টেড। এজন্য আমরা দেশের বা দেশের বাইরের যেকোন ওয়েবসাইট/ডেটা দেখতে পাই। সাবমেরিন ক্যাবলের ম্যাপ দেখলে ব্যাপারটা আরো পরিষ্কার হবে।
Source- https://www.submarinecablemap.com/

তো এখানে দুইটা প্রশ্ন আসতে পারে এক, ইন্টারনেট আমার ঘর পর্যন্ত কিভাবে আসে; দুই, আমরা যে ফোনে ইন্টারনেট ব্যবহার করতেছি সেখানে তো তার দিয়ে কানেক্টেড না, তাহলে কেমনে কি!

বাসাবাড়ি পর্যন্ত ইন্টারনেট সংযোগ পৌঁছানোর ক্ষেত্রে মোট ৩ টা কোম্পানি কাজ করে-
Tier 1 কোম্পানিঃ এরা সাগরে অপটিকাল ফাইভার ক্যাবল বিছিয়ে রেখেছে এবং ভিবিন্ন দেশে ল্যান্ডিং পয়েন্ট রেখেছে। যেমন, বাংলাদেশে বাংলাদেশ সাবমেরিন ক্যাবল কোম্পানি

Tier 2 কোম্পানিঃ এদের কাজ হলো ল্যান্ডিং পয়েন্ট থেকে সংযোগ নিয়ে সারাদেশে সাপ্লাই দেয় এবং নির্দিষ্ট পরিমান ডেটার জন্য নির্দিষ্ট পরিমান এমাউন্ট Tier-1 কে দেয়। যেমন, এয়ারটেল, গ্রামীনফোন, টেলিটক। এরাই সিগ্নালের মাধ্যমে ইন্টারনেট ছড়িয়ে দেয় যা আমরা মোবাইলে ব্যাবহার করি। এই কাজটা  গ্রামীন, এয়ারটেল নিজ নিজ টাওয়ারের মাধ্যমে করে থাকে।

Tier 3 কোম্পানিঃ এরা হচ্ছে ভিবিন্ন ISP কোম্পানি যারা লোকালি বা এরিয়া ভিত্তিক  ইন্টারনেট সংযোগ প্রোভাইড করে। যেমন, ধানমন্ডিতে- MazedaBD, KS Network ! সে সংযোগই অনেকে পিসিতে সরাসরি ক্যাবলের মাধ্যমে কানেকশন নেয় অনেকে বাসার রাউটারে নেয়! রাউটার ওয়াইফাই সিগ্নালের মাধ্যমে নির্দিষ্ট রেঞ্জের মধ্যে ডিভাইসগুলোতে ইন্টারনেট সংযোগ পৌঁছে দেয়।

সো, বুঝাই যাচ্ছে ইন্টারনেট ব্রাউজ মানেই হলো ডাটার দৌড়াদুড়ি। অথ্যাৎ, নির্দিষ্ট একটা ডেটা দেখার জন্য রিকুয়েস্ট করি সে ডেটা টা রিপ্লাই হিসেবে আমার কাছে চলে আসে। আমরা যখন কোন একটা ওয়েবসাইট ব্রাউজ করার চেষ্টা করি সেটা রিকুয়েস্ট হিসেবে ওই ওয়েবসাইট যেখানে হোস্ট করা আছে সেখানে রিকুয়েস্ট হিসেবে যায় তারপর রিপ্লাই হিসেবে আমাদেরকে সেই পেইজটা দেখিয়ে দেয়। ওয়েবসাইটটা যদি দেশের বাইরে কোথাও হোস্ট করা থাকে তাহলে রিকুয়েস্টটা ল্যান্ডিং পয়েন্ট হয়ে সার্ভার পর্যন্ত যত পথ অতিক্রম করে তারপর রিপ্লাই হিসেবে আমাদেরকে ওই পেইজটা দেখিয়ে দেয়।

এরকম হাজার রিকুয়েস্ট এদিক সেদিক প্রতিনিয়ত দোড়াদুড়ি করছে, অগনিত ডেটা অপটিকাল ফাইভার ক্যাবল দিয়ে এদিক সেদিক যাচ্ছে প্রতি মুহুর্তে। কিন্তু একজনের রিকুয়েস্ট অন্যজনের কাছে যায়না, কিম্বা একজনের রিপ্লাই আরেকজনের কাছে যায়না। এই ব্যাপারগুলোর জন্য কম্পিউটার সায়েন্সে নেটওয়ার্কং নামের আলাদা একটা সাবজেক্টই আছে। কারো জানার আগ্রহ থাকলে Data Communication and Networking by Forouzan এবং Computer Networking: A Top-Down Approach by Kurose and Ross পড়তে পারেন।

আমাদের একটা রিকুয়েস্ট কোন কোন দেশ হয়ে সার্ভার পর্যন্ত যায় তা আমরা নিজেরাই চেক করতে পারি অথবা আমরা চাইলেই দেখতে পারি আমাদের ব্রাউজ করা ফেইসবুক বা যেকোন ওয়েবসাইট কোন সার্ভার থেকে আসতেছে। পুরোটাই নেটওয়ার্কিং এর খেলা।

তো কথা হলো ইন্টারনেট সংযোগই যদি না থাকে ডেটা আসবে কিভাবে, রিকুয়েস্ট যাবে কিভাবে? আম্রিকায়  থাকা ফেইসবুকের ডেটা সেন্টার থেকে ফেইসবুকের পেইজ দেখাবে কিভাবে? হোপফুলি ব্যাপারগুলো এখন বুড়িগঙ্গা পানির মত অপরিষ্কার নয়।

তথ্যসূত্র-
১। https://en.wikipedia.org/wiki/Submarine_communications_cable
২। https://www.submarinecablemap.com/
৩। https://en.wikipedia.org/wiki/Internet_service_provider

Tuesday, June 18, 2019

গ্রাফ থিওরি - ২ঃ ভেরিয়েবলে গ্রাফ ইনপুট নেওয়া

চিত্রে একটি আনওয়েটেড গ্রাফ দেখা যাচ্ছে। এই গ্রাফ নিয়ে প্রোগ্রামিং করতে হলে গ্রাফটাকে আগে ইনপুট নিতে হবে। কিন্তু প্রোগ্রামিং এ ইনপুট নিবো কিভাবে? সেখানে তো এরকম দাগ-টাগ টানা যায়না। এজও দেওয়া যায়না। তাইলে কেমনে কি :|

আসলে এখানে যে চিত্র আমরা দেখতে পাচ্ছি তা শুধুমাত্র কল্পনা, ভিজুয়ালাইজেশন বা ডেটা স্টোর করার একটা কৌশল, এছাড়া কিছু না। তাই আপাতত গ্রাফ-ট্রাফ টাইপের চিন্তাভাবনা থেকে থেকে একটু বের হয়ে যাই। ধরে নেই এটা কোন গ্রাফ না। জাস্ট একটা চিত্র। প্রতিটা বৃত্তকে এক একটা ঘর হিসেবে কল্পনা করি-

তো চিত্রে দেখে কি মনে হচ্ছে? ০ থেকে ১, ২, ৩ নাম্বার ঘরে যেতে পারি; ১ থেকে ০ এবং ২ এ যেতে পারি; ২ থেকে ১, ০, ৩, ৫ এ যেতে পারি; ৩ থেকে ০, ৫, ৪ এ সরাসরি যেতে পারি।

তো আমরা যদি ইনপুট এমনভাবে নিতে পারি যাতে এ সম্পর্কগুলো বজায় থাকে তবেই কাজ শেষ। তোমরা নিজেরা কিছুক্ষন চিন্তাভাবনা করো কোন পদ্ধতি খুঁজে পাও কিনা।

যদি কিছু খুঁজে না পাও এইদিকে আসো। উপরের সম্পর্কটাকে একটা লিস্ট আকারে সাজাই-
০-> ১, ২, ৩ //০ থেকে ১, ২, ৩ এ যাওয়া যায়
১-> ০, ২     //১ থেকে ০, ২ তে যাওয়া যায়। এভাবে সবগুলো
২-> ১, ০, ৩, ৫
৩-> ০, ৫, ৪
৪-> ৩, ৫
৫-> ২, ৩, ৪

উপরের লিস্ট টা দেখে তুমি আবার চিত্রটা ড্র করার চেষ্টা করো। যদি তুমি পেরে যাও তাহলে ধরে নাও তোমার অর্ধেক শেখা হয়ে গেছে।

তো এই কাজটা প্রোগ্রামিং এ করবো কিভাবে? তুমি চাইলে ২ডি অ্যারে ব্যাপারটা চেষ্টা করে দেখতে পারো। একটু হিন্ট দেই-

graph[0][1]  //০ থেকে ১ এ যাওয়া যায়
graph[0][2]  //০ থেকে ২ এ যাওয়া যায়
graph[0][3] //০ থেকে ৩ এ যাওয়া যায়
.
.
graph[5][2]
graph[5][3]
graph[5][4]

দেখোতো পারো কিনা! হবে কিনা আমিও শিওর না।  যদি এভাবে পেরে যাও আমাকে জানাবা। ট্রিট দিলেও দিতে পারি ;) (চোখ টিপের মানে হলো শর্ত প্রযোজ্য)

তো, তোমরা যারা জাভা পারো তারা এই কাজটাকে খুব সুন্দরভাবে করতে পারবে। ৬ টা অ্যারেলিস্ট নাও! প্রতিটা অ্যারে লিস্ট ভিতরে তার  সাথে কানেক্টেড নোডগুলোকে ঢুকিয়ে দিলেই ভেজাল শেষ।

ArrayList<Integer>[] graph = new ArrayList[6];  //৬ টা অ্যারেলিস্ট নিলাম। অ্যারেলিস্ট অব অ্যারে

graph[0] = new ArrayList<>();   //প্রথম অ্যারেলিস্ট এর যায়গা এলোকেট করলাম। জাভা জানলে এটা বুঝার কথা

graph[0].add(1);    //০ অ্যারেলিস্টের সাথে ১ কানেক্টেড
graph[0].add(2);
graph[0].add(3);

graph[1] = new ArrayList<>(); // ১ নাম্বার অ্যারেলিস্টের জন্য যায়গা এলোকেট করা
graph[1].add(0);
graph[1].add(2);

এভাবে আমরা কোন একটা অ্যারেলিস্ট দেখেই বলে দিতে পারবো তার সাথে কোন কোন নোড কানেক্টেড আছে। এখানে প্রতিটি অ্যারেলিস্ট এক একটা নোড হিসেবে কাজ করছে। উপরে গ্রাফ স্টোরের যে পদ্ধতি নিয়ে আলোচনা করলাম তার একটা নাম আছে আর তা হলো এডজেসেন্সি লিস্ট।

এই কাজটা সি প্লাস প্লাস এর ভেক্টর দিয়েও করা যায়। বলে রাখা ভালো ভেক্টর এবং অ্যারেলিস্টের কাজ একই। দুইটাই ডায়নামিক্যালি মেমরি এলোকেট করে ডেটা স্টোর করে। তোমাদের কাজ হলো পুরো গ্রাফটাকে স্টোর করা এবং একটা লুপ চালিয়ে কার সাথে কে কানেক্টেড তা প্রিন্ট করে দেখানো উপরের লিস্টের মত।

গ্রাফ স্টোর করার আরেকটা পদ্ধতি আছে তা হলো- এডজেসেন্সি ম্যাট্রিক্স। এই পদ্ধতিতে একটা ২ডি অ্যারেতে গ্রাপ ইনপুট নেওয়া হয়। গ্রাফে যতগুলো নোড আছে ২ডি অ্যারের সাইজ ঠিক ততটাই নিতে হয়। যেমন উপরের গ্রাফের ক্ষেত্রে হবে graph[6][6] !

এখন এইটার ভিতর আমাদের গ্রাফটা ঢুকাবো কেমনে? সেই পুরান কাহিনী। কইলেই বুইঝা ফেলবা

graph[0][0] = 0 //০ এর সাথে ০ এর কানেকশ নাই
graph[0][1] = 1 //০ এর সাথে ১ এর কানেকশন
graph[0][2] = 1 //০ এর সাথে ২ এর কানেকশন
graph[0][3] = 1 //০ এর সাথে ৩ এর কানেকশন
graph[0][4] = 0 //০ এর সাথে ৪ এর কানেকশন নাই
graph[0][5] = 0 //০ এর সাথে ৫ কানেকশন নাই

বুঝতেই পারতেছো কি করছি। যার সাথে যার কানেকশন আছে তার ঘরে ১ বসায়া দিচ্ছি আর যার সাথে যার কানেকশন নাই তার ঘরে বসায়া দিছি শুন্য। এভাবে বাকি নোডগুলোর ক্ষেত্রেও কিন্তু একই কেইস।

graph[1][0]--------------------graph[1][5] // ১ এর সাথে যার যার কানেকশন আছে সেই ঘরে ১ নাহলে ০
graph[2][0]--------------------graph[2][5]
.
.
graph[5][0]--------------------graph[5][5]

যারা বুঝতেছোনা কি ঘটছে তারা নীচের টেবিলটার দিকে তাকাও। নিজের প্র্যাক্টিস করার খাতার ছবিই দিয়ে দিলাম। লিখতে আলসেমি লাগতেছে। যাকগে আমার হাতের লেখার দিকে তাকালে মাইর খাবা :|

অ্যাডজেসেন্সি ম্যাট্রিক্স

এভাবে বাকিগুলো। তারপর আমরা ছোট্ট একটা লুপ চালিয়ে এদের ভিতরে ভেলু চেক করে খুব সহজেই বলে দিতে পারবো কার সাথে কার কানেকশন। তো তোমরা এই কাজটাও কইরালাও এবং লুপ চালায়া প্রিন্ট করো কার সাথে কার প্রেম বালুবাসা!

আমিও ইমপ্লিমেন্ট করছি তোমরা নিজেরা করে তারপর দেইখা নিতে পারো। আমি অ্যাডজেন্সি লিস্ট সি প্লাস প্লাস এর ভেক্টর দিয়ে করছি। তোমরা অন্য যেকোন ল্যাংগুয়েজ বা অ্যারেলিস্ট/লিংক লিস্ট হেন তেন ব্যবহার করতে পারো।

ক্ষ্যাতমার্কা কোডিং করছি এইটারে স্মার্ট করার দায়িত্ব তোমাদের। এই ধরো-
১। অ্যাডজেসেন্সি ম্যাট্রিক্স
২। অ্যাডজেন্সি লিস্ট

টাইম কমপ্লেক্সিটিঃ তো গ্রাফ স্টোরের দুইটা পদ্ধতি দেখলাম। এই দুইটার মধ্যে কোনটা ভালা? তুমি যেহেতু এই পোস্টটা পড়তেছো আমি ধরে নিচ্ছি তুমি টাইম কমপ্লেক্সিটির/মেমরি কমপ্লেক্সিটির কিচ্ছাকাহিনী গেবনে একবার হলেও শুনছো।

অ্যাডজেন্সি ম্যাট্রিক্স এর কথাই আগে কই। একটা গ্রাফে যতগুলো এজ থাকুকনা কেন ডেটা রাখার জন্য তোমাকে n*n সাইজের অ্যারে ডিক্লেয়ার করা লাগবে। উপরের গ্রাফে মোট এজ আছে ৯টা কিন্তু আমরা ইউজ করছি মোট 6*6 = 36 টা ইন্টেজার। মানে এডজেন্সি ম্যাট্রিক্স এর মেমরি কমপ্লেক্সিটি n^2। তবে অ্যাডজেন্সি ম্যাট্রিক্স এর একটা সুবিধা হলো কোন নোডের সাথে কোন নোড কানেক্টেড তা আমরা O(1) কমপ্লেক্সিটিতেই পেয়ে যাবো। যদি বলি ০ এর সাথে ৩ এর কানেকশন আছে কিনা আমরা সিমপ্লি graph[0][3] চেক করলেই বুঝে যাবো। তবে বড় সাইজের কোন গ্রাফের ক্ষেত্রে অ্যাডজেন্সি লিস্ট ইউজ না করাই ভালো। এতে হিতে বিপরীত হতে পারে।


এইবার আসি অ্যাডজেন্সি লিস্টের কথা। অ্যাডজেন্সি ম্যাট্রিক্স এর সমস্যা বুঝতে পারছো সে কেন বেশী মেমরি খায়? আমরা সেখানে কানেক্টেড এবং নন কানেক্টেড সবগুলো নোডেরই ট্র্যাক রাখতেছি। কিন্তু কেন ভাই? যার অস্তিত্বই নাই তার ট্র্যাক রাখার কেন দরকার। অ্যাডজেসেন্সি লিস্ট ঠিক এই কাজটাই করছে। তার সাথে যার কানেকশন শুধু তারে তার দলে রাখছে। এভাবে সবগুলো নোডই এই কাজটা করছে। এতে মেমরি কনজাম্পশন কমে আসছে। এটার মেমরি কমপ্লেক্সিটি কত এবং আর একটা নোডের কানেক্টেড সব নোড খুঁজে বের করতে কি পরিমান সময় লাগবে? এইটা খুঁজে বের করা তোমার কাজ।  আজ এই পর্যন্তই! টা  টু

Wednesday, February 27, 2019

ডিফেন্ডেন্সি সমাচারঃ ম্যাভেন/গ্র্যাডল জিনিসগুলো কি? খায় না মাথায় দেয়?

বিল্ড ইন লাইব্রেরি নিয়ে ত্যানা পেঁচানোঃ তোমরা নিশ্চয়ই সি দিয়ে স্ট্রিং এর ভিবিন্ন অপারেশন করেছো। স্ট্রিং কম্পেয়ার করা, স্ট্রিং এর লেন্থ বের করা, একটা স্ট্রিং এর মধ্যে কয়টা ওয়ার্ড আছে তা কাউন্ট করা মনে আছে? আবার দুইটা নাম্বারের মধ্যে কোনটা ছোট কোনটা বড়, দুইটা ভেরিয়েবলের মধ্যে সোয়াপ করা, স্কয়ার রুট বের করা! এসব কাজ কিন্তু তোমার সি প্রোগ্রামিং ভিতর অলরেডি করা আছে।  যেখানে এই জিনিসগুলো করা থাকে সেগুলোকে বলা হয় লাইব্রেরি। যেমন, স্ট্রিং সমস্ত অপারেশনের জন্য <string> নামের একটা লাইব্রেরি আছে, ম্যাথের সমস্ত অপারেশন করার জন্য <math.h> নামক একটা লাইব্রেরি আছে। এসব লাইব্রেরির ভিতরে অসংখ্য ফাংশন লেখা আছে আমরা সেই ফাংশনগুলোকে দিয়ে কাজ করানোর জন্য সেই ফাংশনগুলোর নাম ধরে কল করলেই পেয়ে যাবো। তার আগে যেটা করতে হয় তা হলো সেই লাইব্রেরি আগে আমার প্রজেক্টে ইঙ্কলুড করে নিতে হবে। যেমন, স্ট্রিং এর জন্য #include <string>, ম্যাথের জন্য #include <math.h> এরকম অসংখ্য লাইব্রেরি আছে সি প্রোগ্রামিং ল্যাঙ্গুয়েজে। যা দিয়ে আমরা অনেক কাজ দ্রুত শেষ করে ফেলতে পারি। দুইটা নাম্বারকে সোয়াপ করার জন্য swap(number1, number2), স্কয়ার রুট বের করার জন্য sqrt(number), স্ট্রিং এর লেন্থ বের করার জন্য strlength(myString[]) এরকম আরো অনেক।

নতুন যারা ডেভেলপমেন্ট শুরু করে বিশেষ করে এন্ড্রয়েড বা জাভা রিলেটেড কোন প্রজেক্টে কাজ করে তাদের প্রথমেই একটা যায়গায় হোঁচট খেতে হয়। সেটা হলো ম্যাভেন/গ্রাডল। এই জিনিসগুলোর উপর নবীনরা এতটাই বিরক্ত যে এটার নাম শুনলেই তারা ভয় পায়। আসলে ব্যপারটা ভয় পাওয়ার কিছু না। আমাদের কাজগুলোকে সহজ করার জন্যই এদের উৎপত্তি। যাইহোক মুল কথায় আসি।

মনে করো, তুমি একটা এন্ড্রয়েড অ্যাপ বানাবা যেখানে ম্যাপ থাকবে। এখানে ম্যাপে মুলত তোমার যে কাজটা বের করতে হবে তা হলো নিয়ারবাই লোকেশন বের করা, এক যায়গায় থেকে অন্য যায়গার দুরত্ব বের করা এরকম অনেক ধরনের ম্যাপ রিলেটেড অপারেশন। কিন্তু তার জন্য তো ম্যাপের দরকার হবে। এক্ষেত্রে তোমার হাতে দুইটা অপশন এক, তোমাকে ম্যাপ তৈরী করা আর দুই, অলরেডী তৈরী করা ম্যাপটা নিয়ে আসা। যেহেতু অলরেডি সেটা তৈরী করা আছে সেটা আবার তৈরী করার কোন মানে নাই। এজন্য যা লাগবে তা হলো ম্যাপের লাইব্রেরিটা প্রজেক্টে নিয়ে আসা। এজন্য তোমাকে যেটা করতে হবে তা হলো ম্যাপের লাইব্রেরিটা  ডাউনলোড করে তা প্রজেক্টে যুক্ত করা। এখানে অনেক ঝামেলা পোহাতে হবে তোমাকে। প্রথমত, প্রজেক্টের কোন ফোল্ডারে রাখবা সেটা নিয়ে কনফিউশন, দ্বিতীয়ত, কোন রকমে যদি ভার্সন পরিবর্তিত হয় তাহলে এই লাইব্রেরি রিমুভ করে  নতুন ভার্সন যুক্ত করা যা অতিরিক্ত ঝামেলা। এমন যদি হতো কেউ একজনকে জাস্ট কমান্ড দিয়ে দিবো সে নিজ থেকেই এসব কিছু ম্যানেজ করে নিবে। ব্যাপারটা আরো সুন্দর হয়না? তোমাকে বাড়তি কোন ঝামেলায় পড়তে হচ্ছেনা। এই কাজটাই আসলে করে ম্যাভেন বা গ্রাডল। এদের প্রত্যেকেরই আলাদা আলাদা স্ট্রাকচার আছে। গ্র্যাডলের ক্ষেত্রে ব্যপারটা এরকম-

 dependencies {  
   compile 'com.google.maps.android:android-maps-utils:0.5+'  
 }  

এই জিনিসটাই গ্র্যাডল ফাইলে লিখলে ম্যাপের জন্য যা যা লাইব্রেরি প্রয়োজন তা সে ডাউনলোড করে নিবে। আর ভার্সন চেঞ্জ হলে ভার্সনের নাম্বার বলে দিলেই  কাজ শেষ। সে তার মত করে ডাউনলোড করে নিবে। এরকম ভিবিন্ন ফ্রেমওয়ার্কের জন্য ভিবিন্ন ডিফেন্ডেন্সি ম্যানেজমেন্ট সিস্টেম আছে। যেমন, স্প্রিং এর জন্য ম্যাভেন।

আশাকরি ম্যাভেন/গ্র্যাডল নিয়ে কনফিউশনগুলো ক্লিয়ার হয়ে গেছে।

Saturday, January 26, 2019

সি পয়েন্টার - ১ঃ ছ্যাঁচড়া তত্ব

আলম এবং সেফাত পরস্পর বন্ধু। সেফাতের একটা অভ্যাস হলো আলমের পিছনে গোয়েন্দাগিরি করা। আই মিন, আলম কোথায় যায় কি করে সেই খবর সে রাখে, আরো ছ্যাঁচড়াভাবে বললে পিছে পিছে ঘুরে আর কি। আলম এতে মাইন্ড করেনা কারন সেফাতকে আলম অনেক বিশ্বাস করে নিজের গফের চেয়েও বেশী। তো, তুমি যদি জিজ্ঞেস করো আলম এখন কোথায়? গুলিস্তান, ধোলাইখাল যেখানেই থাকুক না কেন সে হুবহু বলে দিতে পারবে তাইনা?  আর তোমাকে বিশ্বাস করানোর জন্য সে আলমকে সাথে নিয়ে সেলফিও তুলে দিতে পারবে। ব্যপারটাই স্বাভাবিক।

মনে করো আলমকে আমি ১০ টাকা দিলাম এবং সেফাতকে আলমের পেছনে লাগায়া দিলাম। সেফাত যেহেতু আলমকে ফলো করে আলমকে দিয়ে আমি সে টাকাটা ফিরিয়ে আনতে পারবো তাইনা? একইভাবে সেফাতকে দিয়ে আমি আলমের কাছে টাকাটা পাঠিয়েও দিতে পারবো।

এখানে আলম একটা ভেরিয়েবল হিসেবে কাজ করছে আর ছ্যাঁচড়া সেফাত পয়েন্টার হিসেবে কাজ করছে। পয়েন্টারের কাজই হলো কোন একটা ভেরিয়েবলকে পয়েন্ট করা/অ্যাড্রেস রাখা/ফলো করা একই কথা।  কোন একটা পয়েন্টার যখন কোন একটা ভেরিয়েবলের অ্যাড্রেস রাখে তখন ওই পয়েন্টার সেই ভেরিয়েবলের সমস্ত ইনফরমেশন জানতে পারে।

পয়েন্টার সি প্রোগ্রামিং এর গুরুত্বপূর্ণ এবং শক্তিশালী একটা জিনিস যা সরাসরি মেমরির সাথে জড়িত। এটা দিয়ে অনেক কাজ খুব দ্রুত সময়ে কমপ্লিট করা যায়।

আমরা জানি ভেরিয়েবলের কাজ হলো ডাটা রাখা, যেমন আলম ১০ টাকা রাখছে। পয়েন্টারের কাজ হলো সেই ভেরিয়েবলের অ্যাড্রেস রাখা। কাউকে ফলো করা আর তার অ্যাড্রেস জেনে রাখা একই জিনিস। অনেকে প্রশ্ন করতে পারো ভেরিয়েবলের অ্যাড্রেসটা আবার কি, তাদের জন্য-

আমরা সবাই জানি, ভেরিয়েবল ডিক্লেয়ার করলে সে মেমরিতে একটা যায়গা তৈরী করে নেয় এবং ডাটাটা সেখানে রেখে দেয়।  প্রতিটা যায়গারই একটা অ্যাড্রেস থাকে। পয়েন্টার সেই অ্যাড্রেসটাই জমা রাখে। একটা ভেরিয়েবলের সামনে & বসালেই তার অ্যাড্রেস পাওয়া যায়। নীচের প্রোগ্রামে দেখো আলমের কাছ থেকে কিভাবে তার অ্যাড্রেস জানতেছি

 #include <stdio.h>  
 int main()  
 {  
   int alom = 10; //alom k 10 taka diye dilam B-)  
   printf("Total taka in alom: %d\n", alom);    //alom er kache koto taka ache ta jantechi
   printf("Address of Alom: %d\n", &alom);  //alom ekhon koi ache ta jantechi 
   return 0;  
 }  

 OUTPUT  
 Total taka in alom: 10  
 Address of alom: 6356748  

এখন যে কাজটা করবো তা হল সেফাতকে আলমের পিছনে লাগায়া দিবো। আই মিন, সেফাতকে বলবো আলমের পিছে পিছে ঘুরতে। সেফাতের কাজই হলো যেহেতু আলমের অ্যাড্রেস জেনে রাখা তাই সেফাতের আগে অবশ্যই * দিতে হবে। ছ্যাঁচড়াদের আইডেন্টিফাই করার জন্য তার আগে স্টেরিক ব্যবহার করতে হয়।

 #include <stdio.h>  
 int main()  
 {  
   int alom; //alom aslo 
   alom= 10; //alom re 10 taka dilam 
   int *sefat; //chesra sefat re hajir korlam 
   sefat = &alom; //sefat re alom er address chinaya disi. lou thela 
   printf("alom er kache taka ache: %d\n", alom);    //printing the value of alom
   printf("sefat er kache alom er address: %d\n", sefat); //seeing the address of alom from sefat
   return 0;  
 }  

 OUTPUT  
 alom er kache taka ache: 10  
 sefat er kache alom er address: 6356748  

এখন আমরা চাইলে সেফাতের কাছ থেকে জানতে পারবো আলমের কাছে কত টাকা আছে-
 #include <stdio.h>  
 int main()  
 {  
   int alom = 10;  
   int *sefat;  
   sefat = &alom;  
   printf("%d", *sefat); //Sefat is showing the value in alom   
   return 0;  
 }  

 OUTPUT   
 10  

আবার যদি চাই আলমের কাছের যে টাকা আছে তা পরিবর্তন করতে সেটা কিন্তু আমরা সেফাতকে দিয়েই করতে পারবো। মনে করো আমি সেফাতকে বললাম আলমের কাছে এখন ২০ রাখো। সেফাত দ্রুত আলমের কাছে গিয়ে ২০ টাকা রেখে দিবো।

 #include <stdio.h>  
 int main()  
 {  
   int alom = 10;  
   int *sefat;  
   sefat = &alom;  
   *sefat = 20;  //Changing the value of alom by sefat 
   printf("Current value of alom: %d", alom); //Printing the value of Alom   
   return 0;  
 }  

 OUTPUT   
 10  

দেখতে পাচ্ছো আমরা কিন্তু আলমকে কিছুই বলিনাই। সেফাতরে দিয়ে ঘটনা ঘটিয়ে ফেললাম। অথ্যাৎ, সেফাতকে দিয়ে আলমের ভেলু পরিবর্তন করে ফেললাম। চাইলে কিন্তু আলমের ব্যালান্স শুন্যও করে দিতে পারি। সো, বি কেয়ারফুল।

সেফাত এবং আলমের মধ্যে কিন্তু একটা জিনিসের মিল আছে। তারা কেউ ই একসাথে একাধিক ভেলু রাখতে পারেনা। আলম যেমন একসাথে একাধিক ভেলু রাখতে পারেনা আবার সেফাত একসাথে একাধিক লোককে ফলো করতে পারেনা। সেফাত ডিজিটাল ছ্যাঁচড়া। একসাথে একাধিক মানুষের সাথে চামচামি সে একদমই পছন্দ করেনা। তো, কোনভাবে সেফাতকে যদি কেকা নামের একজন ব্যাক্তির অ্যাড্রেস ধরায়া দিতে পারি তাহলে কিন্তু সে আর আলমকে ফলো না করে কেকাকে ফলো করবে।

  #include <stdio.h>  
  int main()  
  {  
   int alom = 10;  
   int keka = 999;  
   int *sefat;  
   sefat = &alom; // sefat ekhon alom k follow kortese  
   printf("Sefat er point kora address a j value pawa gelo: %d\n", *sefat);  //alomer value
   sefat = &keka; // Sefat ekhon kekappike follow kortese  
   printf("Sefat er point kora jaygay bortoman value: %d\n", *sefat);  //kepapir value
   return 0;  
  }  

 OUTPUT  
 Sefat er point kora address a j value pawa gelo: 10  
 Sefat er point kora jaygay bortoman value: 999  

সেফাত বড্ড বেড়ে গেছে। যাকে তাকে ফলো করে বসতেছে। তুমি চাইলে কিন্তু সেফাতকে পুরা ডাম্ব করে দিতে পারো। মানে সে কাউকেই ফলো করবেনা। এটা করতে হলে সেফাতকে একটা NULL দিয়ে দাও। ভেজাল শেষ। বিশ্বাস না হলে করে দেখো, সে তোমাকে কোন ভালু বা অ্যাড্রেস কিছুই দিতে পারবেনা।

তুমি কি জানো একটা অ্যারের নাম নিজেই একটা পয়েন্টার? অথ্যাৎ, আমাদের যদি একটা অ্যারে হয় int myArr[] = {50, 60, 70, 80, 90} এখানে myArr হলো একটা পয়েন্টার যার কাছে থাকবে প্রথমজনের অ্যাড্রস।  মানে হলো myArr এর কাছে থাকে myArr[0] এর অ্যাড্রেস। বিশ্বাস না হলে *myArr প্রিন্ট করে দেখো তোমার আউটপুট আসবে 50.

  #include <stdio.h>  
  int main()  
  {  
    int myArr[] = {50, 60, 70, 80, 90};  
    printf("%d", *myArr);  
   return 0;  
  }  

 OUTPUT   
 50  

এখন সেই অ্যাড্রেসটা যদি সেফাতকে দেখিয়ে দিতে পারি তাহলে কিন্তু সে এবার কেকাকে ভূলে গিয়ে এখানে এসে myArr[0] কে পয়েন্ট করবে। বুঝতেই পারছো সেফাত এখন কোন ভালুটা আউটপুট দিবে।

 #include <stdio.h>  
 int main()  
 {  
   int myArr[] = {50, 60, 70, 80, 90};  
   int *sefat = myArr;  
   printf("%d", *sefat);  
   return 0;  
 }  

 OUTPUT   
 50  

অ্যারেতে মেমরি ব্লক হিসেবে কাজ করে অথ্যাৎ, সবগুলো ভেরিয়েবল পাশাপাশি যায়গা করে নেয় সেহেতু পয়েন্টারকে এক এক করে বাড়িয়ে আমরা সবগুলো ভেলু এক্সেস করতে পারি। যেমন, সেফাতকে এক বাড়ালে সে পরের অ্যাড্রেসে যাবে, তখন সে ভেলু দিবে আবার এক বাড়ালে তার পরে যাবে এবং তখন সে ভেলু দিবে ৭০। এভাবে আমরা শেষ পর্যন্ত লুপ চালিয়ে কাজটা করতে পারি। নিজে নিজে চেষ্টা করে দেখো। এই ব্যাপারে বিস্তারিত জানতে পারবে এখানে ! আজ এই পর্যন্তই।
টা টা!

Wednesday, January 2, 2019

অব্জেক্ট অরিয়েন্টেড প্রোগ্রামিং - ১২ঃ অ্যানোনিমাস ইনার ক্লাস

অ্যানোনিমাস ইনার ক্লাস হলো এক ধরনের ক্লাস যার কোন নাম নাই। এই কথা শুনে অনেকে হয়তো টাস্কি খেয়ে গেছো; নামবিহীন আবার ক্লাস হয় নাকি! একটু পরেই ব্যপারটা আরো ক্লিয়ার হবে। নীচের প্রোগ্রামটা খেয়াল করো। আমি একটা PersonalData নামের একটা ইন্টারফেস তৈরী করলাম এবং সেটাকে ইমপ্লিমেন্ট করার জন্য MyClass নামের আরেকটা ক্লাস তৈরী করলাম এবং কাজটি সম্পর্ন করলাম।

Program - 1: 

 public interface PersonalData {  
      int x = 20;   
      public void getAge();   
 }  

 public class MyClass implements PersonalData {  
      @Override  
      public void getAge() {  
           System.out.println("The age is: "+ x);  
      }  
 }  

 public class MainClass {  
      public static void main(String[] args) {  
           MyClass myClass = new MyClass();  
           myClass.getAge();  
      }  
 }  

 OUTPUT  
 20  

মেইন মেথড থেকে কল করে আমি সিমপ্লি getAge() মেথডটি ব্যবহার করতে পারবো, যার আউটপুট হবে ২০। পুরো কাজটা অক্ষত রেখে কোনভাবে যদি MyClass ক্লাসটিকে হাওয়া করে দিতে পারি তখনই Anonymous Inner ক্লাসের ব্যপারটা চলে আসে। আমরা কাজটা করেই ফেলি!

Program - 2:

 public interface PersonalData {  
      int x = 20;   
      public void getAge();   
 }  

 public class MainClass {  
      public static void main(String[] args) {  
           /* Creating the object of the interface implementing the   
            overloading method */  
           PersonalData personalData = new PersonalData() {  
                @Override  
                public void getAge() {  
                     System.out.println("The age is: "+ x);  
                }  
           };  
           personalData.getAge();  
      }  
 }  

 OUTPUT  
 20  

কোন পার্থক্য খুঁজে পেয়েছো? এখানে কিন্তু MyClass নামের ক্লাসটি নাই। কিন্তু আমাদের আউটপুট ঠিকই আছে। এখানে আমরা ইন্টারফেসটি ইমপ্লিমেন্ট করার জন্য আলাদা ক্লাস ইউজ না করে সরাসরি ইন্টারফেসটির অব্জেক্ট তৈরী করেছি এবং তার আনইমপ্লিমেন্টেড মেথডগুলো ইমপ্লিমেন্ট করে দিয়েছি একইসাথে। এর ফলে আমরা মাঝখানের ক্লাসটিকে এভয়েড করে ফেলছি। এখানে MyClass ই Anynomous ক্লাস হিসেবে কাজ করছে আর যেহেতু এটি MainClass নামক অন্য একটি ক্লাসের ভিতর কাজ করছে তাই একে Anynomous Inner ক্লাস বলা হয়। তাহলে আমরা অ্যানোনিমাস ইনার ক্লাসের একটা সংজ্ঞায় উপনীত হতে পারি-

অ্যানোনিমাস ইনার ক্লাস হল এমন এক ধরনের ক্লাস যেটা কোন ইন্টারফেস বা অ্যাবস্ট্র্যাক্ট ক্লাসের সাবক্লাস তৈরী করা ছাড়াই অব্জেক্ট তৈরী করতে সহায়তা করে।


Sunday, August 26, 2018

ডাটা স্ট্রাকচার - ৩ঃ লিঙ্ক লিস্ট

অ্যারে বনাম লিঙ্ক লিস্টঃ

আমরা ইতোমধ্যে জানি যে, অ্যারে তে মেমরিগুলো পরস্পর সজ্জিত থাকে। অথ্যাৎ, অ্যারে একটা মেমরি ব্লক হিসেবে কাজ করে। সেই ভেরিয়েবলগুলোকে অ্যাক্সেস করার ক্ষেত্রে এই সুবিধাটা কাজে লাগানো হয়। যেহেতু অ্যারের ভেরিয়েবলগুলো পর পর মেমরিতে যায়গা নেয় সেহেতু প্রথম ভেরিয়েবলের অ্যাড্রেস পেয়ে গেলে আমরা সবগুলো পেয়ে যাই। চিত্রে খেয়াল করো-


লিঙ্ক লিস্টের কাজও মাল্টিপল ডাটা রাখা তবে কনসেপ্ট টা অ্যারের চেয়ে ভিন্ন। লিঙ্ক লিস্টে ভেরিয়েবলগুলো পাশাপাশি থাকেনা। কিন্তু পরে কোনটার পরে কোনটা থাকবে তা বলে দেওয়া থাকে। অথ্যাৎ, প্রতিটা ভেরিয়েবলে তার পরের জনের অ্যাড্রেস বলে দেওয়া থাকে। উপরের লিস্টই যদি আমি লিঙ্ক লিস্ট আকারে সাজাতে চাই তাহলে এমন হবে- 
এখানে ভেরিয়েবলগুলো পাশাপাশি থাকার কোন বাধ্যবাধকতা নাই। খেয়াল করো প্রতিটা নোডের দুইটা অংশ আছে। একটা অংশে তার ডাটা আর অন্য অংশে তারপরে কোন নোড থাকবে তার অ্যাড্রেস। প্রতিটা নোডেই এরকম ভেলু এবং তার পরের নোডের অ্যাড্রেস দেওয়া থাকে। যেহেতু যেকোন নোডে গেলেই পরের নোডের অ্যাড্রেস পেয়ে যাই সেহেতু আমরা সেই অ্যাড্রেস ধরে সবাইকে অ্যক্সেস করতে পারবো। বুঝতে সমস্যা হচ্ছে? দাঁড়াও বুঝিয়ে বলছি- 

মনে করো তোমরা ৪ বন্ধু- রহিম, করিম, রাকিব এবং সাকিব। একজন লোক তোমার বাড়ি অ্যড্রেস জানে। মনে করো লোকটার নাম সেফুদা। সেফুদাকে সবাই চিনে এবং মোটামুটি ওই এলাকার স্থায়ী। মনে করো ট্রাম্প নামের একজন ব্যক্তি তোমাদের সবার বাড়িতে আসতে চাচ্ছেন তথ্য সংগ্রহ করার জন্য। যেহেতু ট্রাম্প সেফুদাকে চিনে সেহেতু ট্রাম্প সেফুদার কাছ থেকে তোমার বাড়ির অ্যড্রেস টা জেনে নিলো। তারপর সেই অ্যড্রেস ধরে তোমার বাড়িতে চলে এলো এবং প্রয়োজনীয় তথ্য সংগ্রহ করলো। তোমার বাড়িতে আসার পর ট্রাম্প তোমার বন্ধুর অ্যড্রেস জিজ্ঞেস করলো তুমি রহিমের অ্যড্রেস বলে দিলে! তারপর তিনি রহিমের বাসায় গিয়ে করিমের অ্যড্রেস জানতে চাইলেন এবং চলে গেলেন করিমের বাসায়। তারপর রাকিবের বাসায় এবং শেষমেশ সাকিবের বাসায় গিয়ে আর কোন অ্যড্রেস পেলেননা এবং থেমে গেলেন। এভাবে সবার বাসায় তিনি চলে যেতে সক্ষম হলেন এবং সবার তথ্য সংগ্র করে ফেললেন। খেয়াল করো লোকটা কিন্তু এক এক করে তোমাদের সবার বাসায় চলে গেলো। এক্ষেত্রে তিনি কিভাবে গেলেন? তোমরা যে অ্যড্রেস বললে সেই অ্যড্রেস ধরেই! এখানে তোমরা তাঁকে দুইটা জিনিস দিয়েছো একটা হলো তোমাদের বাসার তথ্য যেটা ট্রাম্প সংগ্রহ করতে এসেছেন আরেকটা হল তোমার বন্ধুর অ্যড্রেস।  এখানে তোমরা প্রত্যেকেই একেকটি ভেরিয়েবল হিসেবে কাজ করেছো। লোকটার সবার বাড়িতে যাওয়ার পথ হল 
সেফুদা->রহিম->করিম->রাকিব->সাকিব। এই পথটা অন্য রকমও হতে পারতো। সেটা নির্ভর করে তোমরা কে কার অ্যড্রেস বলছো। 

উপরের আলোচনা থেকে এতটুকু স্পষ্ট যে, লিঙ্ক লিস্টে প্রতিটি ভেরিয়েবল দুইটা জিনিস বহন করতে হবে। একটা হলো আমাদের ডাটা/তথ্য এবং আরেকটা হল তার পরের ভেরিয়েবল অ্যড্রেস। তার মানে আমাদের ইন্টেজার ডাটা রাখার জন্য প্রতিটি ভেরিয়েবল একই সাথে একটা ইন্টেজার এবং একটা পয়েন্টার বহন করার সক্ষমতা থাকতে হবে। কিন্তু সি তে এমন কোন ডাটা টাইপ নাই যে একই সাথে ডাটা এবং পয়েন্টার বহন করে। আমরা জানি, ইন্টেজার শুধু একটা ইন্টেজার, ডাবল শুধু একটা ডাবল নিতে পারে।  সেক্ষেত্রে আমাদের একটি ডাটা টাইপ তৈরী করতে হবে যে একই সাথে একটি ইন্টেজার এবং একটি পয়েন্টার রাখতে পারে। সি তে ডাটা টাইপ তৈরী করার জন্য স্ট্রাকচার ব্যবহার করা হয়। 

 #include <stdio.h>  
 #include <stdlib.h>  
 struct Node  
 {  
   int data;  
   struct Node *next;  
 };  

নতুন যে ডাটা টাইপ তৈরী হল তা হচ্ছে- struct Node।  এটি এমন একটা ডাটা টাইপ যা একসাথে ইন্টেজার এবং একটা পয়েন্টার রাখতে পারে। কিন্তু আমরা চাইলে অন্যান্য প্রিমিটিভ ডাটা টাইপের মত (int, double, float) এক অক্ষরে করে নিতে পারি। এর জন্য আমাদের typedef নামক কিওয়ার্ড এর হেল্প নিতে হবে। এই কিওয়ার্ড দিয়ে একটা ডাটা টাইপকে রিনেম করার পদ্ধতি হল- 
typedef old_datatype new_datatype. যেমন উপরের struct Node কে যদি node এ কনভার্ট করতে চাই তাহলে লিখতে হবে- 

 typedef struct Node node  

এর ফলে node নামক একটি ডাটা টাইপ তৈরী হল যা দিয়ে আমরা এই টাইপের একটা ভেরিয়েবল ডিক্লেয়ার করতে পারি।

কথা হল- যেখানে অ্যারে আছে সেখানে এত ঝামেলায় যাওয়ার কি দরকার? আসলে অ্যারেতে কিছু সমস্যা আছে যে কারনে লিঙ্ক লিস্টের সুত্রাপাত।

যেমন ধরো, তুমি ১০০০০ স্টুডেন্ট এর তথ্য রাখার জন্য একটা সফটওয়্যার তৈরী করেছো। তুমি তথ্যগুলোগুলো ১০০০০ সাইজের একটা অ্যারেতে রেখেছো। তোমার তৈরী করা সফটওয়্যারটি ইউজারের কাছে চলে যাওয়ার পরে নিন্মোক্ত সমস্যার সম্মুখীন হতে পারে-
১। যদি কখনো ১০০০০ এর অধিক স্টুডেন্ট এর তথ্য রাখার দরকার পড়ে ইউজার তা করতে পারবেনা।
২। যদি ইউজারের স্টুডেন্ট কখনো ৫০০০০ এর অধিক না হয় তাহলে বাকি ৫০০০০ মেমরি অপচয় হবে
৩। ডাটাগুলো রিঅর্ডার করা কিম্বা মাঝখানে কোন ডাটা যুক্ত করা সময়সাপেক্ষ।

এই সমস্যাগুলো থেকে পরিত্রানের জন্য লিঙ্ক লিস্ট এসেছে। লিঙ্ক লিস্টে শুরুতে কোন ধরনের মেমরি এলোকেট করেনা। যখন দরকার হবে তখনই সে মেমরি এলোকেট করবে এবং ডাটা রাখবে। অথ্যাৎ, প্রয়োজন বেসিসে সে মেমরিতে যায়গা নিবে। যে পরিমান মেমরি দরকার সে সেই পরিমানই মেমরিতে যায়গা নিবে। এতে করে আমাদে উপরোক্ত প্রব্লেমগুলো সল্ভ হয়।
তো, ইতোমধ্যে আমরা জেনি  যে নোড নামের একটা ডেটা টাইপ আমাদের হাতে আছে। এই ডেটা টাইপ দিয়ে যদি কোন ভেরিয়েবল ডিক্লেয়ার করি সেই ভেরিয়েবল একইসাথে ডেটা রাখতে পারে এবং অন্য একটা নোডের অ্যাড্রেস রাখতে পারে। এই কথা বুঝতে পারলে লিংক লিস্ট ইমপ্লিমেন্টেশনের ৬০ ভাগ কাজ শেষ। উপরের গল্পটাকেই কোড আকারে লিখে ফেলি-

   node *Rahim, *Karim, *Rakib, *Sakib; //Declaring all node pointer variable to keep data  
   node *Sefuda, *Trump; //Declaring sefuda to keep the data of you/first person and Trump to travel all house  
   /*Allocating memory and keep data for all*/  
   Rahim = (node*)malloc(sizeof(node));  
   Rahim->data = 10;  
   Karim = (node*)malloc(sizeof(node));  
   Karim->data = 20;  
   Rakib = (node*)malloc(sizeof(node));  
   Rakib->data = 30;  
   Sakib = (node*)malloc(sizeof(node));  
   Sakib->data = 40;  
   Rahim->next = Karim; //Rahim can tell the address of next person Karim  
   Karim->next = Rakib; //Karim can tell the address of next person Rakib  
   Rakib->next = Sakib; //Rakib can tell the address of next person Sakib  
   Sakib->next = NULL; //There is no person after sakib. He tells NULL or none  
   Sefuda = Rahim;   //Sefuda knows the address of first person  
   Trump = Sefuda;   //Trump also knows the address of first person  
   /*Trump now visiting to all house */  
   while(Trump!= NULL)  
   {  
     printf("%d ", Trump->data);  
     Trump = Trump->next;  
   }  

এই কাজটাকে অন্যভাবেও করা যায়-
  sefuda = NULL; //Intially there is no person in the list. so, sefuda knows nothign  
   person = (node*)malloc(sizeof(node)); //create memory for first person  
   person->data = 10; //assigning data for first person Rahim  
   sefuda = person;  //Sefuda knows the first person  
   person->next = (node*)malloc(sizeof(node)); //creating memory for next person, Karim  
   person->next->data = 20; //Assigning data for Karim  
   person->next->next = (node*)malloc(sizeof(node)); //creating memory for next person Rakib  
   person->next->next->data = 30; //Assigning data for Rakib  
   person->next->next->next = (node*)malloc(sizeof(node)); //creating memory for sakib  
   person->next->next->next->data = 40; //assigning data for sakib  
   person->next->next->next->next = NULL; //There no person in next   
   //we can print all the data in same way  
   printf("%d ", person->data);  
   printf("%d ", person->next->data);  
   printf("%d ", person->next->next->data);  
   printf("%d ", person->next->next->next->data);  

অথবা এইভাবে -
 sefuda = NULL;  
   person = (node*)malloc(sizeof(node));  
   person->data = 10;  
   sefuda = person;  
   //person->next = (node*)malloc(sizeof(node));  
   //person->next->data = 20;  
   person->next = (node*)malloc(sizeof(node));  
   person = person->next;  
   person->data = 20;  
   //person->next->next = (node*)malloc(sizeof(node));  
   //person->next->next->data = 30;  
   person->next = (node*)malloc(sizeof(node));  
   person = person->next;  
   person->data = 30;  
   //person->next->next->next = (node*)malloc(sizeof(node));  
   //person->next->next->next->data = 40;  
   person->next = (node*)malloc(sizeof(node));  
   person = person->next;  
   person->data = 40;  
   //person->next->next->next->next = NULL;  
   person->next = NULL;  
   //we can print all the data in same way  
   printf("%d ", sefuda->data);  
   printf("%d ", sefuda->next->data);  
   printf("%d ", sefuda->next->next->data);  
   printf("%d ", sefuda->next->next->next->data);  

অথবা এইভাবে-
  int value, i;  
   sefuda = NULL;  
   for(i = 1; i<=4; i++)  
   {  
     scanf("%d", &value);  
     if(sefuda == NULL)  
     {  
       person = (node*)malloc(sizeof(node));  
       person->data = value;  
       person->next = NULL;  
       sefuda = person;  
     }  
     else  
     {  
       person->next = (node*)malloc(sizeof(node));  
       person = person->next;  
       person->data = value;  
       person->next = NULL;  
     }  
   }  

অথবা-
 int value, i;  
   sefuda = NULL;  
   for(i = 1; i<=4; i++)  
   {  
     scanf("%d", &value);  
     if(sefuda == NULL)  
     {  
       person = (node*)malloc(sizeof(node));  //creating first node   
       person->data = value;  //adding value   
       person->next = NULL;  //we don't know who is gonna next   
       sefuda = person; //let it know the sefuda/head that it is the first node   
     }  
     else  
     {  
       person = (node*)malloc(sizeof(node)); //allocating person for second node, which will replace previous value. No issue on that   
       person->data = value;  //adding value   
       person->next = sefuda; //next upcoming node will be pointing the sefuda/head  
       sefuda = person; //now second node became sefuda(first node) which pointing to the previous node   
     }  

Tuesday, August 7, 2018

অব্জেক্ট অরিয়েন্টেড প্রোগ্রামিং - ১১ঃ জাভা নেস্টেড ক্লাস

একটা ক্লাসের ভিতর এক বা একাধিক থাকলেই তাকে নেস্টেড ক্লাস বলে। সাধারনত একই ধরনের সবগুলো ক্লাসকে একটি ক্লাসের আন্ডারে নিয়ে আসার জন্য এই কাজটা করা হয়। যেমন একটা ইউনিভার্সিটির Student, Department, Faculty আমরা একটা ক্লাস University এর আন্ডারে নিয়ে আসতে পারি। নীচের প্রোগ্রামটি খেয়াল করো-

 public class University {  
      public class Student{  
            String studentName;  
            int studentAge;  
            String studentId;  
      }  
      public class Department{  
           String departmentName;  
           String departmentCode;  
      }  
      public class Faculty{  
           String facultyName;  
           String facultyId;  
      }  
      public class Staff{  
           String staffName;  
           String staffId;  
      }  
 }  

এখানে একটা ইউনিভার্সিটির জন্য লেখা সকল ক্লাসকে আলাদা আলাদা না লিখে একটা ক্লাসে লিখে ফেললাম। Inner ক্লাসের অব্জেক্ট তৈরী করতে হলে একটু ভিন্ন পন্থা অবলম্বন করতে হয়। Inner ক্লাসের রেফারেন্স Outer ক্লাসের রেফারেন্সের মাধ্যমে পাওয়া যায় আর Inner ক্লাসের কন্সট্রাক্টর আউটার ক্লাসের অব্জেক্ট এর মাধ্যমে পাওয়া যায়।

 OuterClassReference.InnerClassReference object_name = OuterClassObject.new InnerClass Constructor  

নীচের প্রোগ্রামটিতে University ক্লাসটির জন্য অব্জেক্ট তৈরী করা হয়েছে-

 public class MainClass {  
      public static void main(String[] args) {  
           University university_ob = new University();  
           University.Student student_ob = university_ob.new Student();  //creating student object
           University.Department department_ob = university_ob.new Department();  //creating department object
           University.Faculty faculty_ob = university_ob.new Faculty();  //creating faculty object
           University.Staff staff_ob = university_ob.new Staff();  //creating staff object
      }  
 }  

আবার আমরা না চাইলে অব্জেক্ট তৈরী করা ছাড়াও এসব ব্যবহার করতে পারি। সেক্ষেত্রে Inner ক্লাসগুলোকে Static করে দিলেই কাজ শেষ।

 public class University {  
      public static class Student{  
            static String studentName;  
            static int studentAge;  
            static String studentId;  
      }  
      public static class Department{  
           static String departmentName;  
           static String departmentCode;  
      }  
      public static class Faculty{  
           static String facultyName;  
           static String facultyId;  
      }  
      public static class Staff{  
           String staffName;  
           String staffId;  
      }  
 }  

 public class MainClass {  
      public static void main(String[] args) {  
           University university_ob = new University();  
           University.Student.studentName = "Rakib";  
           University.Department.departmentName = "CSE";  
           University.Faculty.facultyName = "Prf. xyz";  
      }  
 }  

দেখা যাচ্ছে শুধুমাত্র University দিয়ে তার সকল ডাটা আমি অ্যাক্সেস করতে পারছি। জিনিসটা অনেক সাজানো দেখাচ্ছে তাইনা? এভাবে অনেকগুলো ক্লাসকে একটা ক্লাসের আন্ডারে এনে সুন্দরভাবে অর্গানাইজ করা যায়।

সুবিধাসমুহঃ
১। ক্লাসগুলোকে গ্রুপিং করা যায়
২। যেহেতু ইনার ক্লাস থেকে আউটার ক্লাসের প্রাইভেট ফিল্ডগুলো অ্যাক্সেস করা যায় সেহেতু ইনক্যপসুলেশন আরো কার্যকরীভাবে অ্যাপ্লাই করা যায় ।
৩। নেস্টেড ক্লাসগুলো পড়ার উপযোগী এবং মেনেজ করা সহজ।

Monday, August 6, 2018

অব্জেক্ট অরিয়েন্টেড প্রোগ্রামিং - ১০ঃ জাভা this এবং super কিওয়ার্ড

আমরা সাধারনত জানি এক ক্লাস থেকে অন্য ক্লাসের ফিল্ড/ কন্সট্রাক্টর/মেথড ইউজ করতে হলে হলে তার অব্জেক্ট তৈরী করে সেই অব্জেক্ট এর মাধ্যমে অ্যাক্সেস করতে হয়।

কিন্তু ধরা যাক, এমন একটা পরিস্থিতি তৈরী হল যখন কোন ক্লাস থেকে তার সুপার ক্লাসের কোন ফিল্ড, কন্সট্রাক্টর বা মেথডকে কল করার প্রয়োজন পড়লো;  আবার এমন কোন পরিস্থিতি হল যখন একই ক্লাস থেকে ওই ক্লাসেরই কোন ফিল্ড, কনস্ট্রাক্টর, মেথডকে কল করার প্রয়োজন হল। তখন আমাদের super এবং this কিওয়ার্ড এর হেল্প নিতে হয়।

super কিওয়ার্ড হল এমন কিওয়ার্ড যা নির্দিষ্ট কোন ক্লাসের সুপার ক্লাস রেফারেন্স হিসেবে কাজ করে আর this কিওয়ার্ড দিয়ে একই ক্লাসের কন্সট্রাক্টর/ফিল্ড/মেথড কে কল করা হয়। মানে ওই ক্লাসের রেফারেন্স হিসেবে কাজ করে। এজন্য এদেরকে ডট দিয়েই অ্যাক্সেস করা যায়।

 public class Animal {  
      private String name;  
      private int age;  
      public Animal(String name, int age) {  
           this.name = name;  
           this.age = age;  
      }  
      public String getName() {  
           return name;  
      }  
      public int getAge() {  
           return age;  
      }  
 }  

 public class Human extends Animal {  
      private String gender;  
      public Human(String name, int age, String gender) {  
           super(name, age);   //instantiate using super class constructor   
           this.gender = gender; //instantiate it in here   
      }  
      public String getGender() {  
           return gender;  
      }  
      public void think()  
      {  
           System.out.println("Can think");  
      }  
 }  

Human ক্লাসে আমরা name এবং age কে ইনিসিয়াল করেছি সুপার ক্লাসের কন্সট্রাক্টরের সাহায্যে। কারন এটা অলরেডি ওখানে করা আছে। আর বাকি যেটা আছে তা আমরা এখানেই করে নিলাম। আবার খেয়াল করো আমরা কিন্তু this দিয়ে একই ক্লাসের gender কে কল করেছি। this এবং super এর কাজ একই শুধু পার্থক্য হল this কাজ করে একই ক্লাস হিসেবে আর super কাজ করে super ক্লাস হিসেবে।

 public class StartUp {  
      public static void main(String[] args) {  
           Human aHuman = new Human("Rakib", 23, "Male");  
           System.out.println(aHuman.getName());  
           System.out.println(aHuman.getAge());  
           System.out.println(aHuman.getGender());  
      }  
 }  

উপরের প্রোগ্রামটি রান করলে নিন্মোক্ত আউটপুট দেখাবেঃ
 Rakib  
 23  
 Male  

super এবং this দিয়ে যত ধরনের কল করা হয় তা এক দৃষ্টিতে দেখানো হলঃ


Thursday, August 2, 2018

অব্জেক্ট অরিয়েন্টেড প্রোগ্রামিং - ৯ঃ oop তে static কেন ব্যবহার করা হয়


static মানেই হল স্থির বা নির্দিষ্ট। কোন ক্লাসের ভেরিয়েবল/ফিল্ড বা মেথড ব্যবহার করতে হলে তার অব্জেক্ট তৈরী করতে হয়।  কারন ভেরিয়েবল/ফিল্ড বা মেথড অব্জেক্ট এর অধীনে থাকে। এজন্য কোন ক্লাসের অব্জেক্ট তৈরী করা ছাড়া তার প্রোপার্টিগুলো ব্যবহার করা যায়না। ধরা যাক আমরা একটা ইউনিভার্সিটির স্টুডেন্ট এর তথ্য রাখবো। তথ্য হিসেবে স্টুডেন্ট এর নাম,বয়স এবং ইউনিভার্সিটি কোড রাখবো। নীচের প্রোগ্রামটি খেয়াল করো-

প্রোগ্রাম- ১ঃ
 public class Student {  
      String name;  
      int age;  
      int university_code;  
 }  

 public class MainClass {  
      public static void main(String[] args) {  
           Student student1 = new Student();  
           Student student2 = new Student();  
           student1.age = 23;  
           student1.name = "Rakib";  
           student1.university_code = 100;  
           student2.name = "Rigan";  
           student2.age = 24;  
           student2.university_code = 100;  
           System.out.println("Name: "+ student1.name+", Age: "+student1.age+ ", University Code: "+ student1.university_code);  
           System.out.println("Name: "+ student2.name+", Age: "+student2.age+ ", University Code: "+ student2.university_code);  
      }  
 }  


OUTPUT
 Name: Rakib, Age: 23, University Code: 100  
 Name: Rigan, Age: 24, University Code: 100  

আমরা জানি প্রতিটা অব্জেক্টই মেমরিতে আলাদা আলাদা যায়গা করে নেয়। উপরে প্রোগ্রামটিতে যে ঘটনা ঘটেছিলো-

চিত্রঃ নন স্ট্যাটিক ফিল্ডগুলো অব্জেক্ট তৈরীর সাথে সাথে মেমরিতে আলাদা যায়গা নেয়

যেহেতু দুইটা অব্জেক্ট এর জন্যই মেমরি আলাদা আলাদা যায়গা তৈরী হয়েছে সেহেতু দুইটা ডাটাই স্বতন্ত্র বা একে অপরের সাথে মিশ্রিত হয়নি।

কিন্তু যদি আমরা এদেরকে static করে দেই তাহলে তা আর অব্জেক্ট এর অধীনে থাকবেনা। সেটা সরাসরি, ক্লাসের অধীনে থাকবে। যে কারনে সেটা মেমরিতে একবারের বেশী যায়গা নেয়না। যেহেতু ক্লাসের অধীনে চলে আসে সেহেতু যেকোন static ফিল্ডকে তার ক্লাসের নাম দিয়েই পাওয়া যাবে।

প্রোগ্রাম - ২ঃ
 public class Student {  
      static String name;  
      static int age;  
      static int university_code;  
 }  

 public class MainClass {  
      public static void main(String[] args) {  
           Student.name = "Rakib";  
           Student.age = 23;  
           Student.university_code = 100;  
           System.out.println("Name: "+ Student.name+ ", Age: "+ Student.age+ ", University Code: "+ Student.university_code);  
      }  
 }  

OUTPUT
Name: Rakib, Age: 23, University Code: 100  

লক্ষ্য করো এখানে কিন্তু কোন অব্জেক্ট তৈরী করিনি। সরাসরি ক্লাসনেম দিয়েই Student ক্লাস এর প্রোপার্টি গুলো পেয়ে যাচ্ছি। খেয়াল করো আমরা কিন্তু এখন দ্বিতীয় স্টুডেন্ট এর কোন ডাটা রাখতে পারছিনা। কারন এখানে কোন অব্জেক্ট তৈরী করা হয়নাই।  তাহলে অব্জেক্ট তৈরী করে দেখি কি ঘটনা ঘটে-

প্রোগ্রাম - ৩ঃ

 public class Student {  
      static String name;  
      static int age;  
      static int university_code;  
 }  

 public class MainClass {  
      public static void main(String[] args) {
  
           //Create object for student1  
           Student student1 = new Student();  

           //create object for student2  
           Student student2 = new Student();  

           //add data for student1  
           student1.age = 23;  
           student1.name = "Rakib";  
           student1.university_code = 100; 
 
           //add data for student2  
           student2.name = "Rigan";  
           student2.age = 24;  
           student2.university_code = 100; 
 
           //Print data for student1  
           System.out.println("Name: "+ student1.name+", Age: "+student1.age+ ", University Code: "+ student1.university_code);  

           //Print data for student2  
          System.out.println("Name: "+ student2.name+", Age: "+student2.age+ ", University Code: "+ student2.university_code);   
      }  
 }  

 OUTPUT  
 Name: Rigan, Age: 24, University Code: 100  
 Name: Rigan, Age: 24, University Code: 100  

খেয়াল করো দুইটা আলাদা আলাদা ডাটা দেওয়ার পরও আমরা শুধু Rigan এর ডাটাই দুইবার দেখতে পারছি। অথ্যাৎ, শেষে যে ডাটা টা দিলাম সেটাই দুইবার দেখাচ্ছে।

এটার কারন হল কোন ফিল্ড যখন static থাকে তখন সেটা আর অব্জেক্ট এর আন্ডারে থাকেনা।সেজন্যই দুইটা অব্জেক্ট এর জন্য name, age, এবং university_code এর আলাদা আলাদা যায়গা তৈরী হয়নি। তাই দুইজনের ডাটাই এক যায়গায় বা একই ভেরিয়েবলে অ্যাসাইন হয়েছে। আর আমরা সবাই জানি ভেরিয়েবলে সবসময় শেষের ডাটাই থাকে। নীচের ছবিটি খেয়াল করো-

চিত্রঃ স্ট্যাটিক ফিল্ডগুলো মেমরিতে একবারই যায়গা নেয়। যতবারই অব্জেক্ট তৈরী হোকনা কেন


তার মানে এতটুকু স্পষ্ট static  ফিল্ডগুলো একটা ক্লাসের সব অব্জেক্ট শেয়ার করে। তাহলে আমরা এমন ফিল্ডগুলো static করবো যা সবার জন্য একই হবে। যেমন উপরের উদাহরণে  একটা ইউনিভার্সিটির সকল স্টুডেন্টদের university_code একই হবে। সুতরাং, তার জন্য আলাদা আলাদা মেমরি তৈরী করার দরকার নাই। সেটা একবারই তৈরী হবে এবং সকল অব্জেক্ট তা শেয়ার করবে। তাই আমরা এটাকেই static করে দিবো।

প্রোগ্রাম - ৪ঃ
 public class Student {  
       String name;  
       int age;  
      static int university_code;  
 }  

 public class MainClass {  
      public static void main(String[] args) {  
           //Create object for student1  
           Student student1 = new Student();  
           //create object for student2  
           Student student2 = new Student();  
           //Setting university code   
           Student.university_code = 100;  
           //add data for student1  
           student1.age = 23;  
           student1.name = "Rakib";  
           //add data for student2  
           student2.name = "Rigan";  
           student2.age = 24;  
           //Print data for student1  
           System.out.println("Name: "+ student1.name+", Age: "+student1.age+ ", University Code: "+ student1.university_code);  
           //Print data for student2  
          System.out.println("Name: "+ student2.name+", Age: "+student2.age+ ", University Code: "+ student2.university_code);   
      }  
 }  

 OUTPUT  
 Name: Rakib, Age: 23, University Code: 100  
 Name: Rigan, Age: 24, University Code: 100  

এখানে আউটপুট কিন্তু প্রোগ্রাম-১ এর মতই।  শুধু পার্থক্য হল অব্জেক্ট যতগুলোই তৈরী হোকনা কেন university_code এর জন্য মেমরি একবারই তৈরী হবে এবং প্রতিটা অব্জেক্টই ওই মেমরি অ্যাড্রেসই ব্যবহার করবে। এতে মেমরি অপচয় কম হবে। কারন যেহেতু university_code একটা ইউনিভার্সিটির সকল স্টুডেন্ট এর জন্য একই সেহেতু এর জন্য বার বার মেমরি এলোকেট করার দরকার নাই। একটা university_code দিয়ে সকল অব্জেক্ট এর জন্য কাজ করতে পারবো।
চিত্রঃ স্ট্যাটিক ফিল্ডগুলো মেমরিতে একবার যায়গা নিলেও নন স্ট্যাটিক ফিল্ডগুলো যতবার অব্জেক্ট তৈরী হয় ততবারই নতুন যায়গা তৈরী করে। 


এতে মেমরির অপচয় রোধ হল।  প্রথম প্রোগ্রামে university_code এর জন্য দুইবার মেমরি এলোকেট হয়েছে। অথ্যাৎ, মেমরিতে ৩২x২ = ৬৪ বিট যায়গা দখল হয়েছে। যদি আমি মোট ১০০ টা অব্জেক্ট তৈরী  করতাম তাহলে ৩২x১০০ = ৩২০০ বিট যায়গা দখল হতো। যা অপ্রয়োজনীয়।

কিন্তু প্রোগ্রাম - ৪ যতটা অব্জেক্ট তৈরী হোকনা কেন university_code এর জন্য মাত্র ৩২ বিটেই সকল অব্জেক্ট এর কাজ হয়ে যাবে। এতে আমাদের অপ্রয়োজনীয় মেমরি তৈরী করার দরকার পড়েনাই। মেমরি লস কমে গেছে।

যেহেতু এটি ক্লাস এর অধীনে থাকে সেহেতু অব্জেক্ট না থাকলেও static ভেরিয়েবলের জন্য মেমরি বরাদ্ধ থাকবে। অথ্যাৎ, ক্লাস তৈরীর সাথে সাথেই static ফিল্ডগুলো মেমরিতে যায়গা তৈরী করে নেয়। এভাবে আমরা static ব্যবহার করে মেমরি কনজাম্পশন  কমিয়ে আনতে পারি।